
모든 것이 마치 V12 엔진을 탑재한 것과 같습니다.
이달 13일 이카이푸와 제로원위시가 두 번째 제품인 Yi-Large 클로즈드 소스 모델을 출시했다. 출시된 지 보름도 채 안 되어 호랑이를 두려워하지 않는 신세대에서 장강의 파도를 앞서가는 막강한 그룹으로 거듭난 Yi-Large.
지난주 대형 모델 경기장 챗봇 경기장에 '나도 좋은-gpt2-chatbot'이라는 신비한 모델이 갑자기 등장해 GPT-4-Turbo, Gemini 1 .5 Pro, Claude 3 0pus보다 순위가 직접적으로 높으며, Llama-3-70b 및 주요 국제 제조업체의 기타 인기 기본 모델.
이 신비한 모델은 GPT-4o의 테스트 버전이기도 합니다. OpenAI CEO인 Sam Altman도 GPT-4o 출시 이후 LMSYS 아레나 블라인드 테스트의 테스트 결과를 직접 다시 게시하고 인용했습니다.
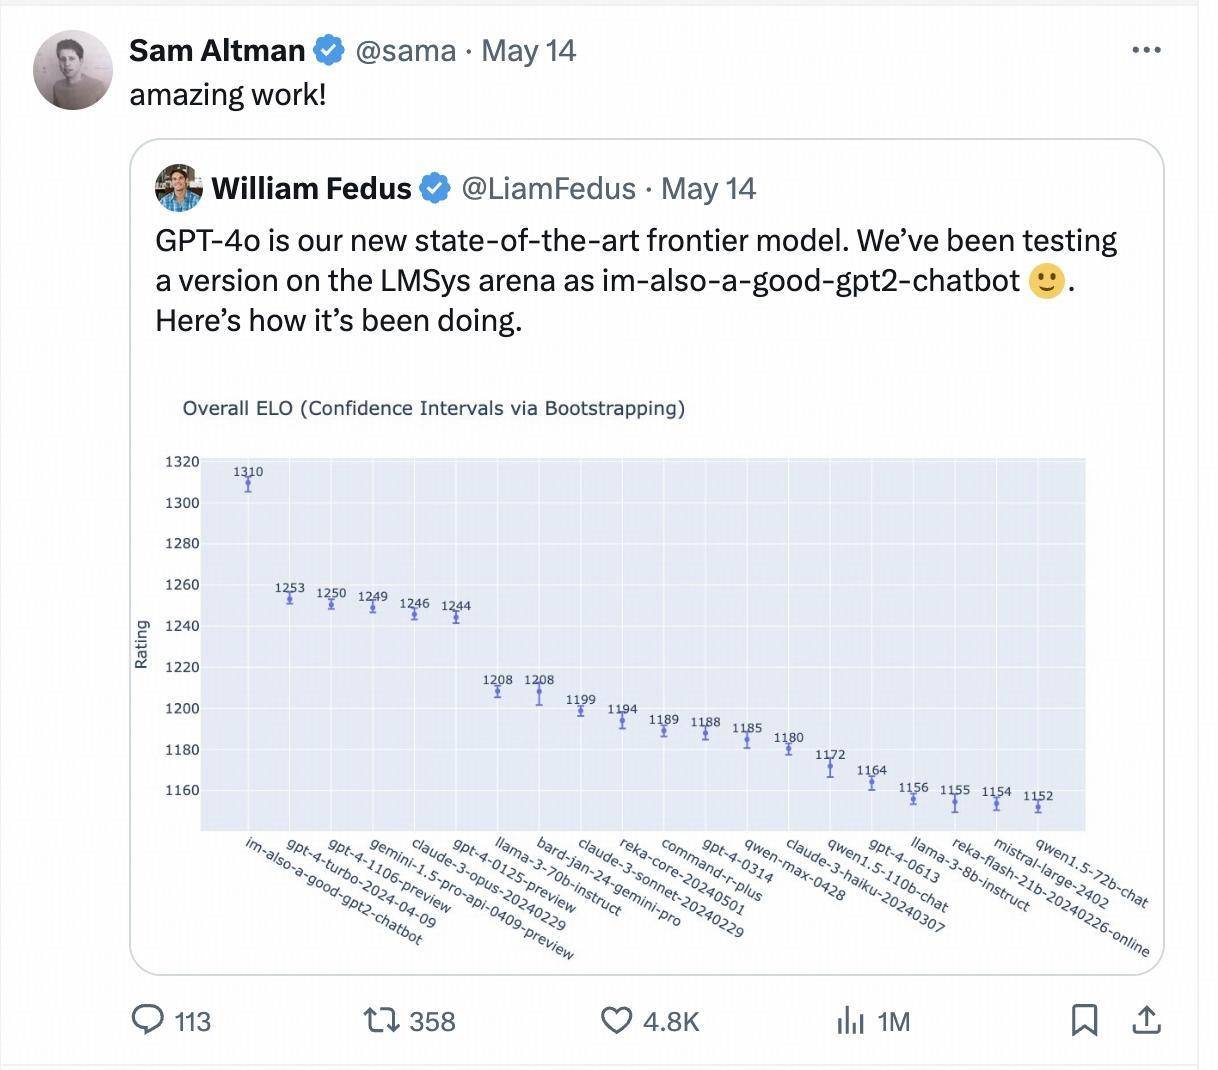
일주일 후 최신 업데이트된 순위에서는 '나도 좋은 gpt2-chatbot'이라는 다크호스 스토리가 다시 한번 등장했는데, 이번에 순위가 급격하게 오른 모델이 중국 대형업체에서 제출됐다. 모델 회사 Zero One Wan. 수천억 개의 매개변수를 가진 "Yi-Large" 비공개 소스 대형 모델입니다.
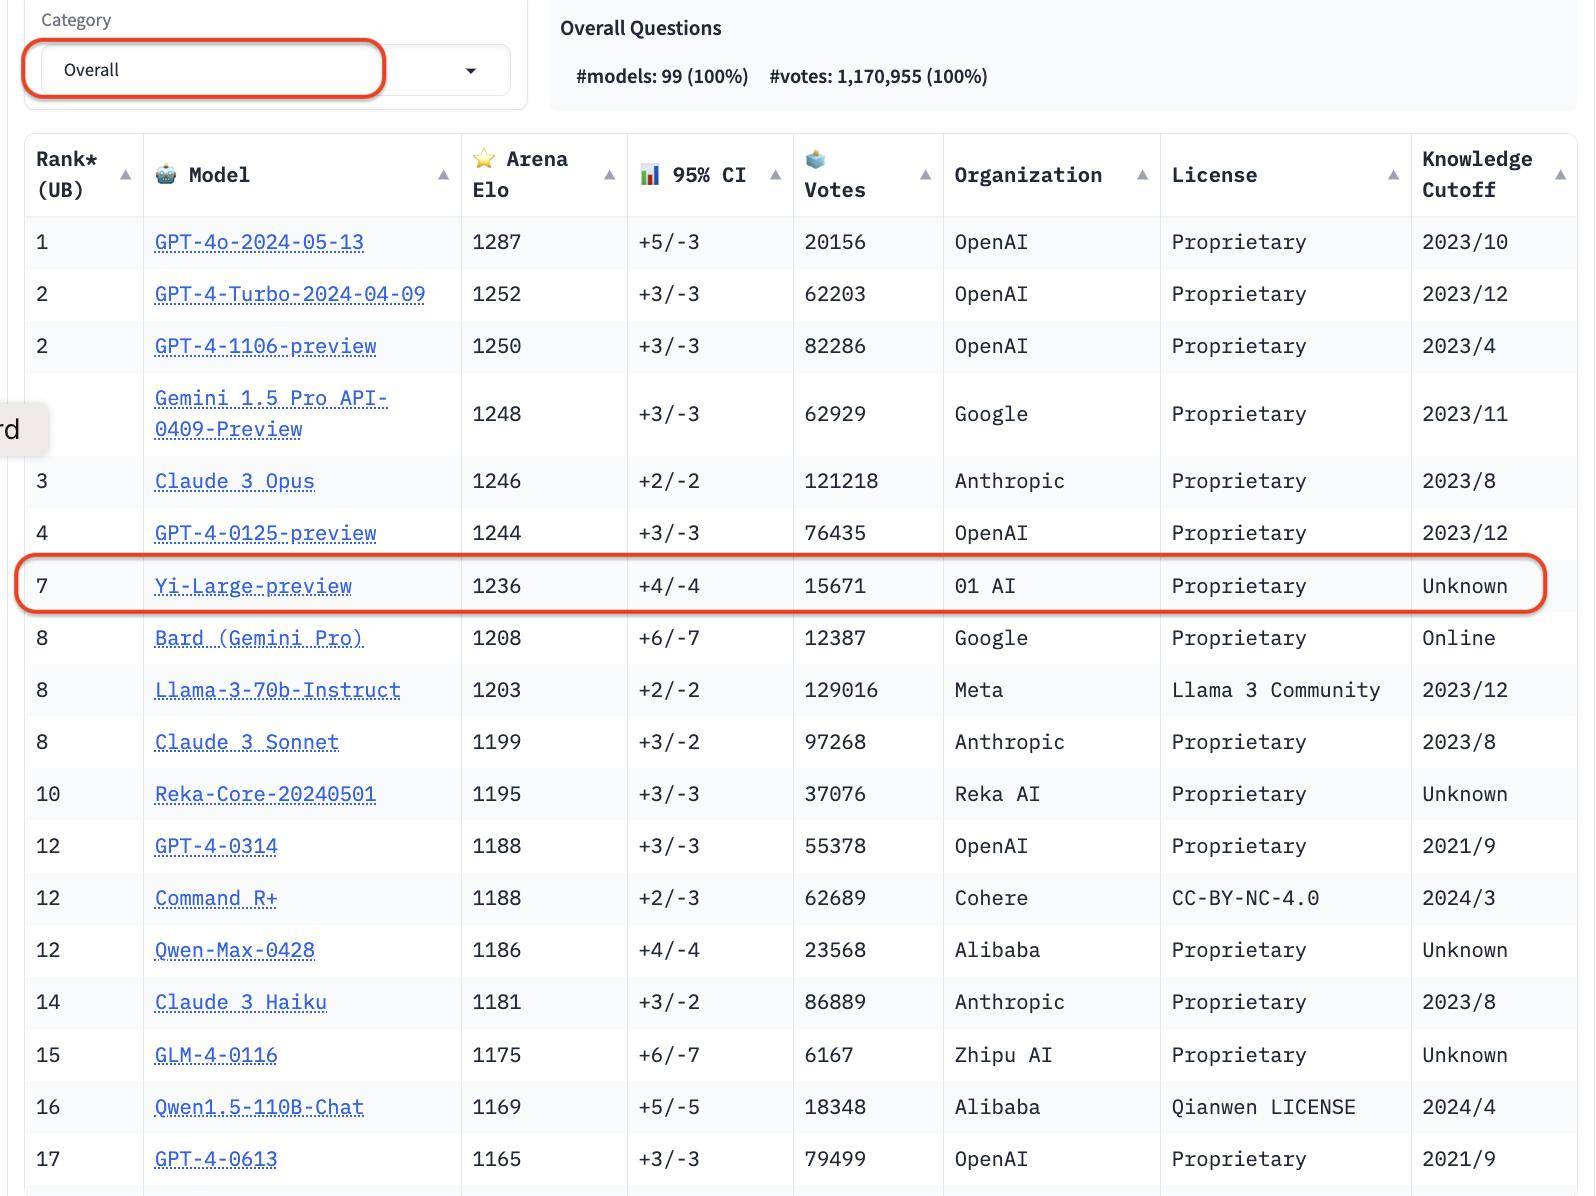
LMSYS 블라인드 테스트 아레나 최신 순위에서 Yi-Large의 최신 1000억 매개변수 모델인 Yi-Large는 Llama-3-70B와 Claude 3 Sonnet을 제치고 세계 7위, 중국 대형 모델 중 1위에 올랐습니다. ; 중국 순위는 GPT4o와 공동 1위입니다.
공개 연구 기관인 LMSYS Org(Large Model Systems Organization)가 출시한 챗봇 아레나는 OpenAI, Anthropic, Google, Meta 등 해외 주요 기업들의 정면 대결이 되었으며, 대규모 투표 기능도 오픈하였습니다. .
이로써 Lingyiwuwu는 전체 목록에서 상위 10위 안에 자체 모델을 보유한 유일한 중국 대형 모델 회사가 되었습니다.
전체 목록에서 GPT 시리즈는 상위 10개 중 4개를 차지합니다. 기관별로 정렬하면 01W01.AI는 OpenAI, Google, Anthropic에 이어 두 번째로 공식적으로 세계 최고의 대형 모델 기업 캠프에 진입했습니다.
이제 '세계 1위가 되자'라는 슬로건은 단순한 슬로건이 아닌, '되어가는' 슬로건이 된 것 같습니다.
중국 점수는 세계 1위에 올랐고, '두뇌 불태우기' 블라인드 테스트는 세계 2위를 기록했다.
미국 시간 기준 2024년 5월 20일에 업데이트된 LMSYS 챗보트 아레나 블라인드 테스트 결과는 지금까지 누적된 글로벌 유저 1,170만 명 이상의 실제 투표를 바탕으로 이뤄졌습니다.
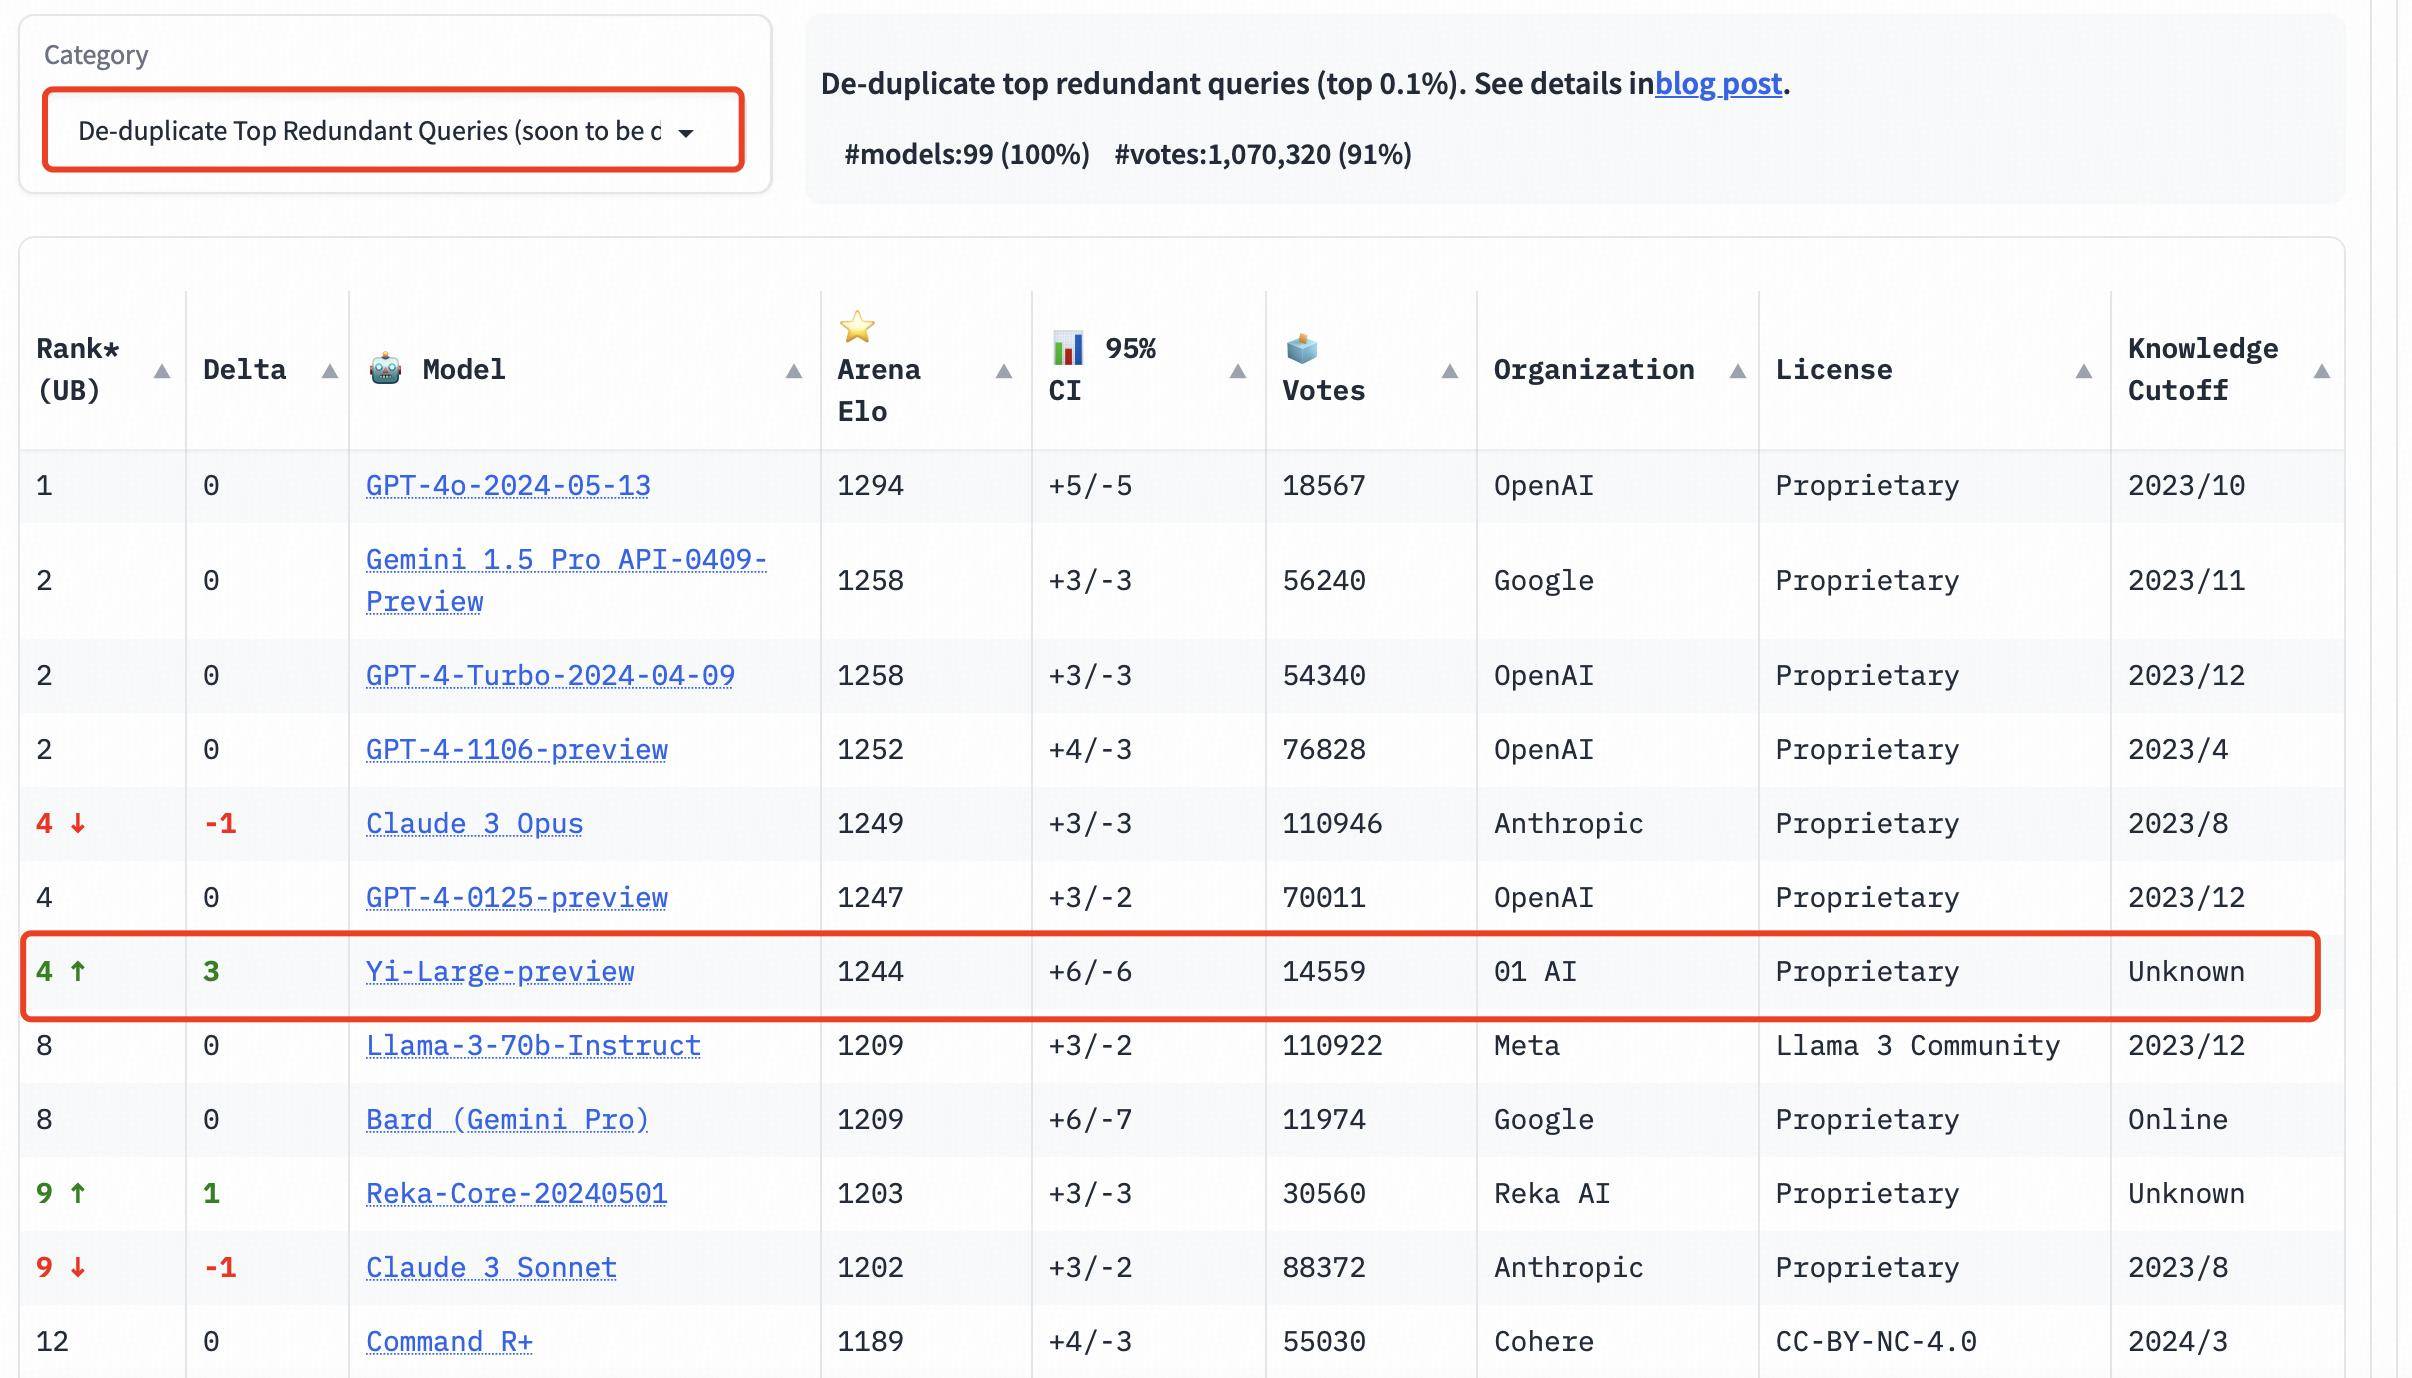
LMSYS는 Chatbot Arena 쿼리의 전반적인 품질을 향상시키기 위해 중복 제거 메커니즘도 구현하고 중복 쿼리를 제거한 후 목록을 발행했다는 점을 언급할 가치가 있습니다.
이 새로운 메커니즘은 순위의 정확성에 영향을 줄 수 있는 지나치게 반복적인 "안녕하세요"와 같이 지나치게 중복되는 사용자 프롬프트를 제거하도록 설계되었습니다.
LMSYS는 중복 쿼리를 제거한 목록이 향후 기본 목록이 될 것이라고 공개적으로 밝혔습니다.
중복 쿼리를 제거한 후 전체 목록에서 Yi-Large의 Elo 점수는 더욱 높아져 Claude 3 Opus 및 GPT-4-0125-preview와 함께 4위를 차지했습니다.
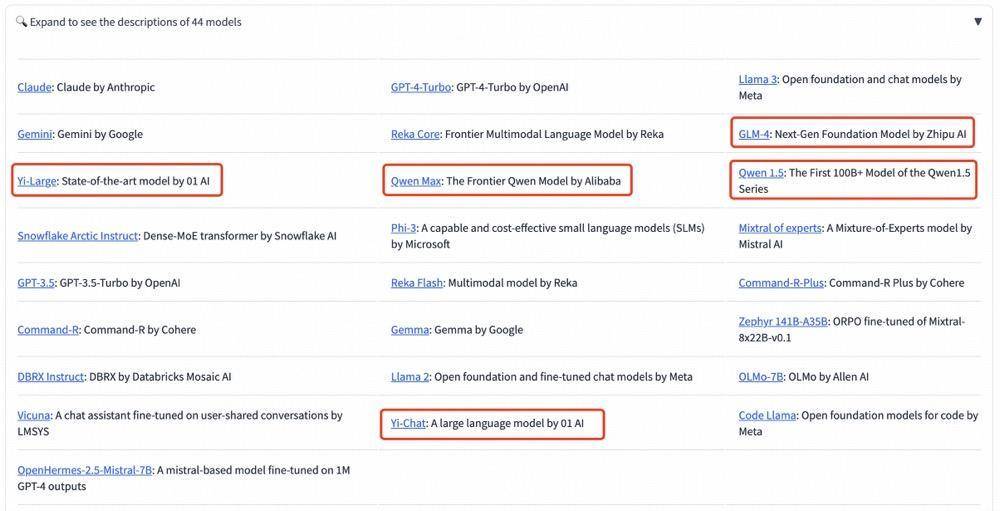
LMSYS는 전체 목록 외에도 영어, 중국어, 프랑스어 3가지 새로운 언어 평가를 추가했으며, 글로벌 대형 모델의 다양성에 집중하기 시작했습니다. Yi-Large는 중국어 목록에서 GPT4o와 함께 1위를 차지했으며 GLM-4도 중국어 목록에서 좋은 성적을 거두었습니다.
국내 대형 모델 제조사 중에는 알리바바의 Qwen-Max와 Zhipu의 GLM-4가 모두 유난히 좋은 성적을 거두었다.
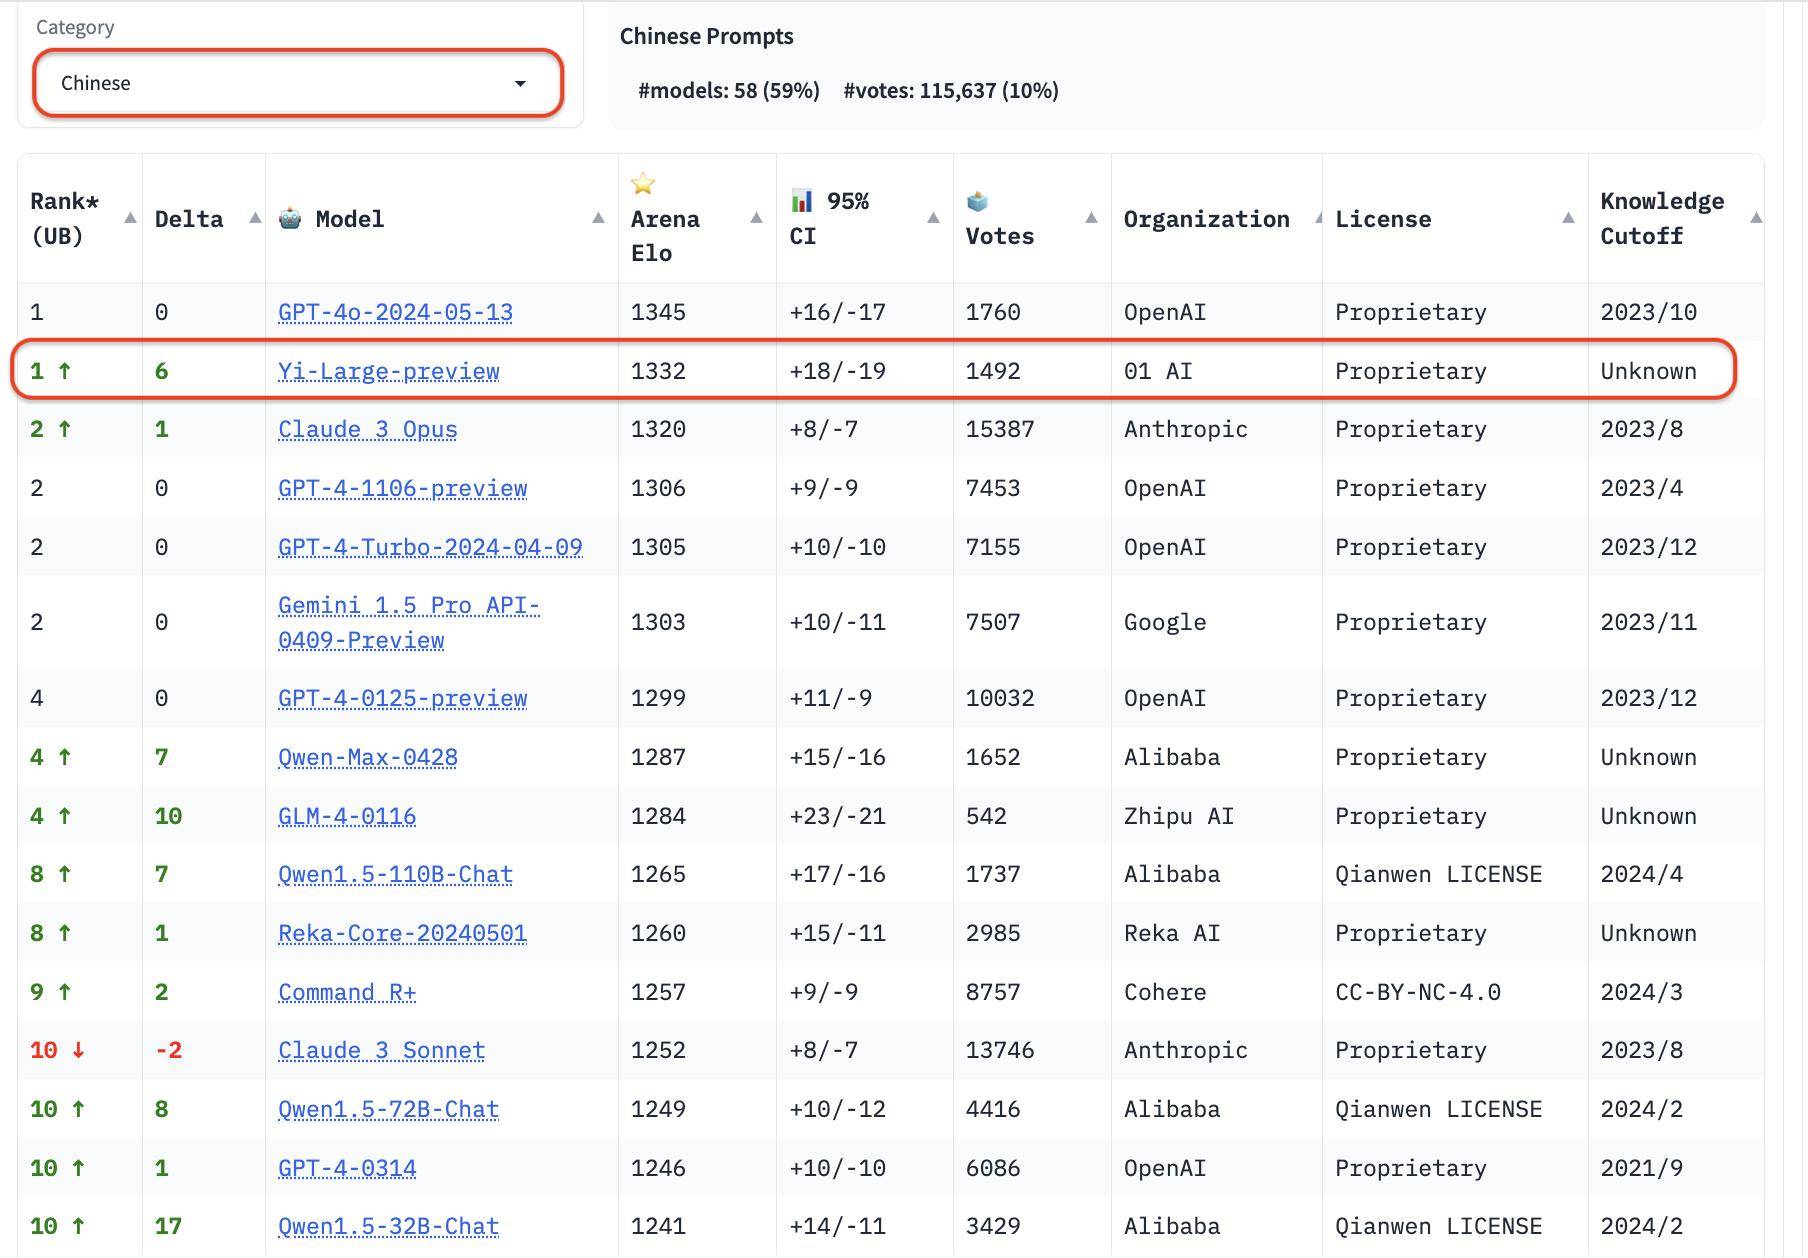
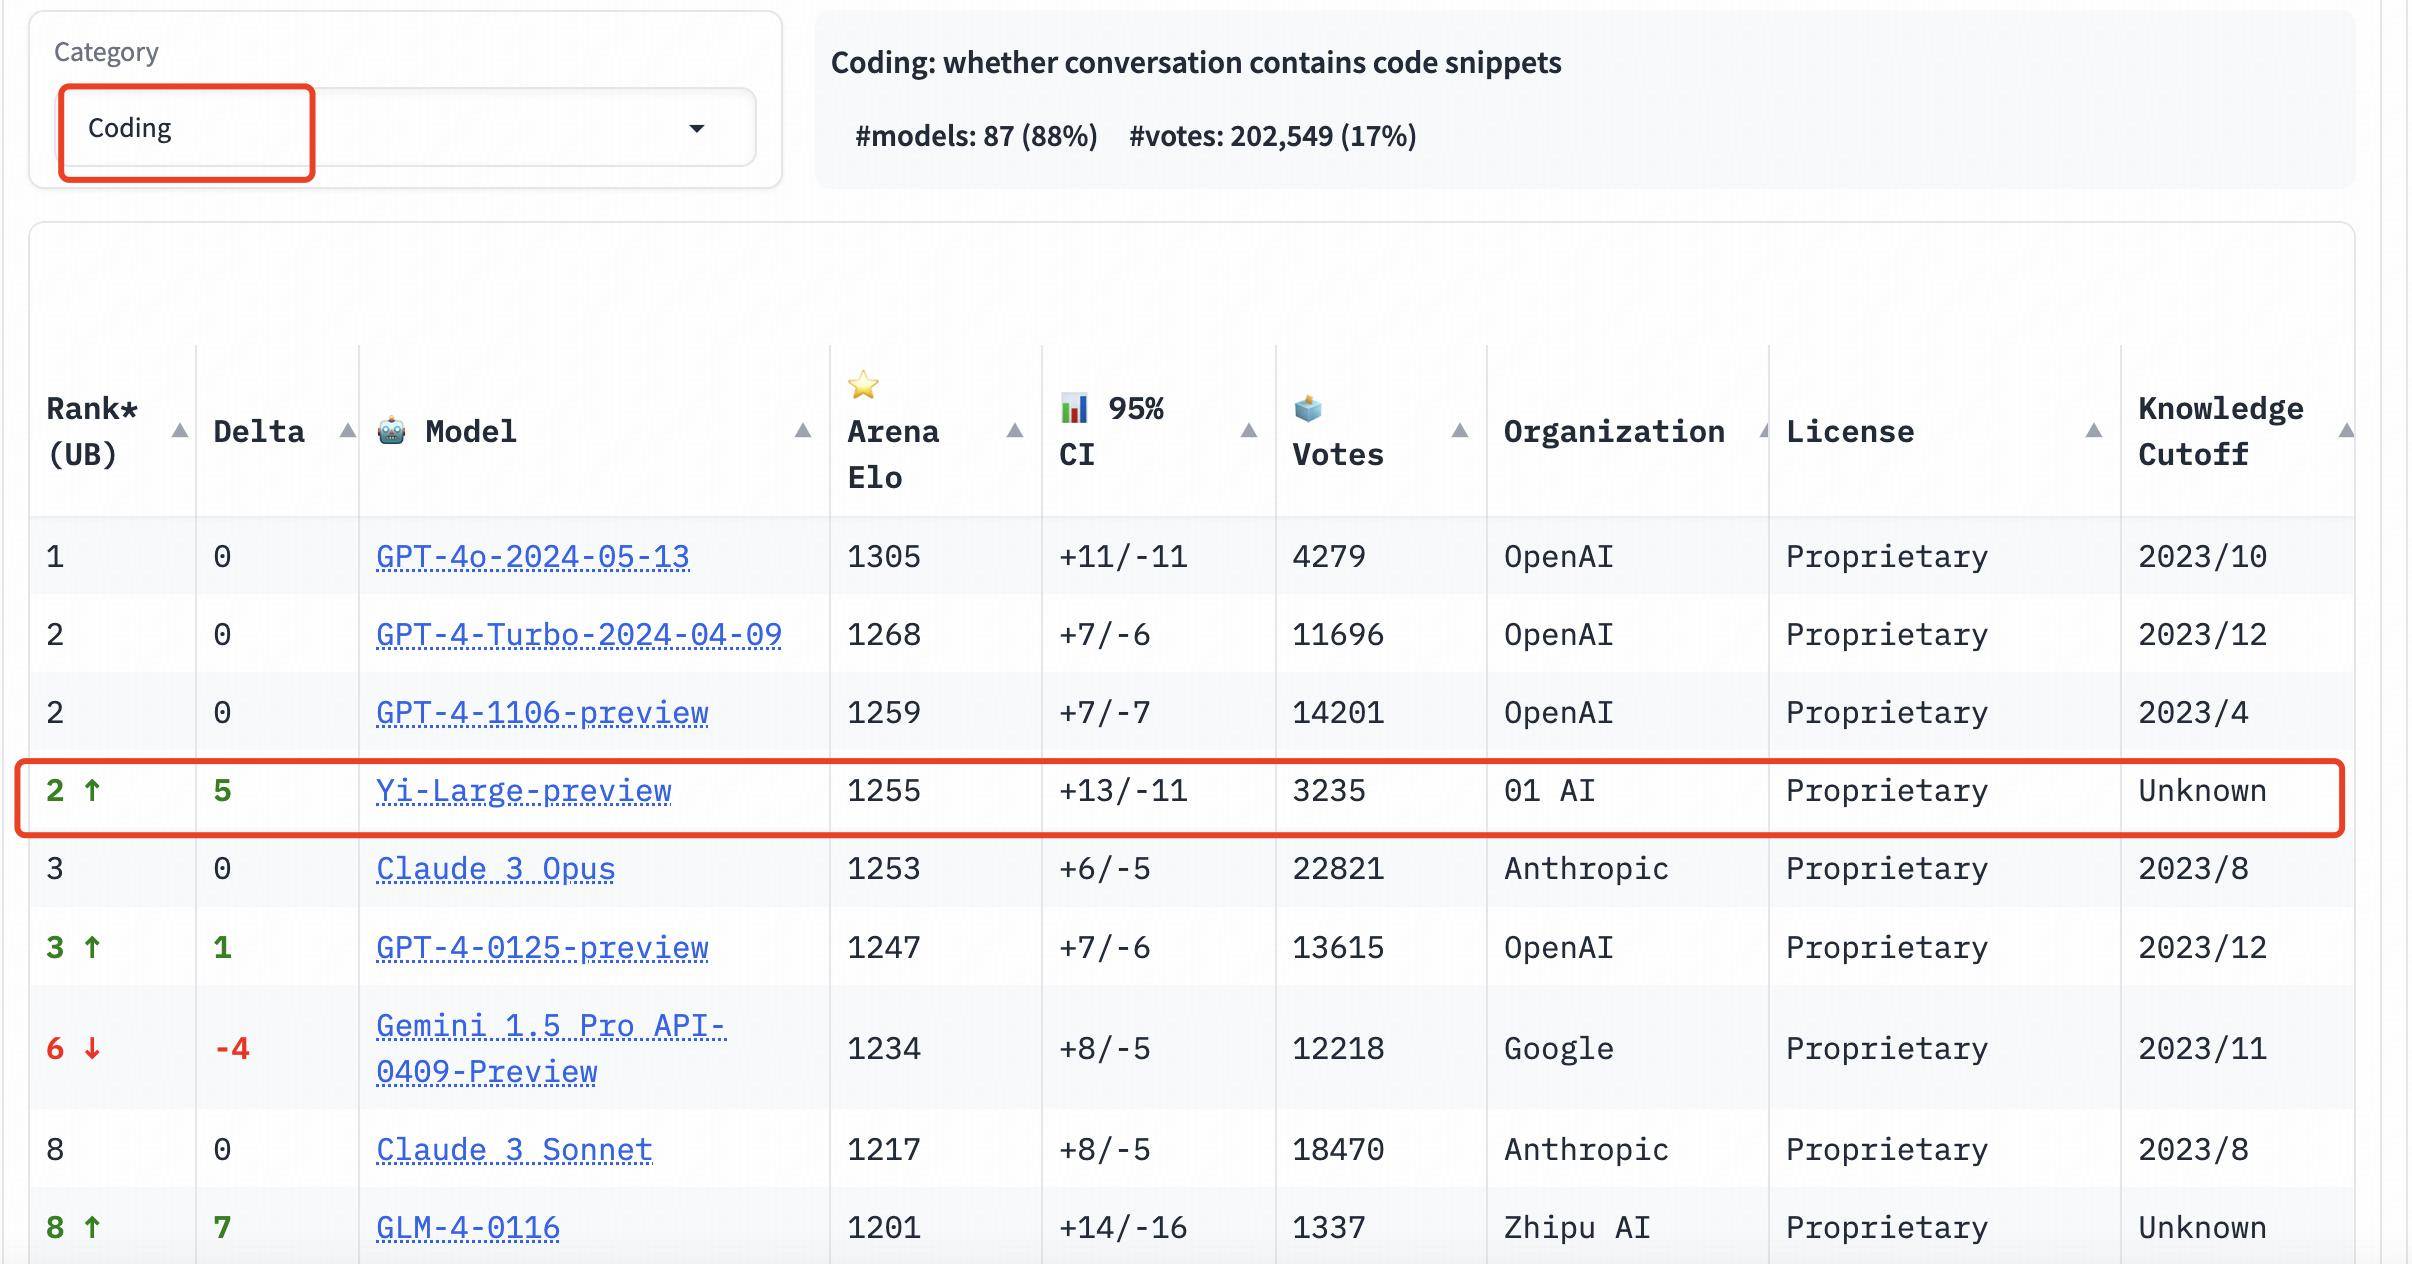
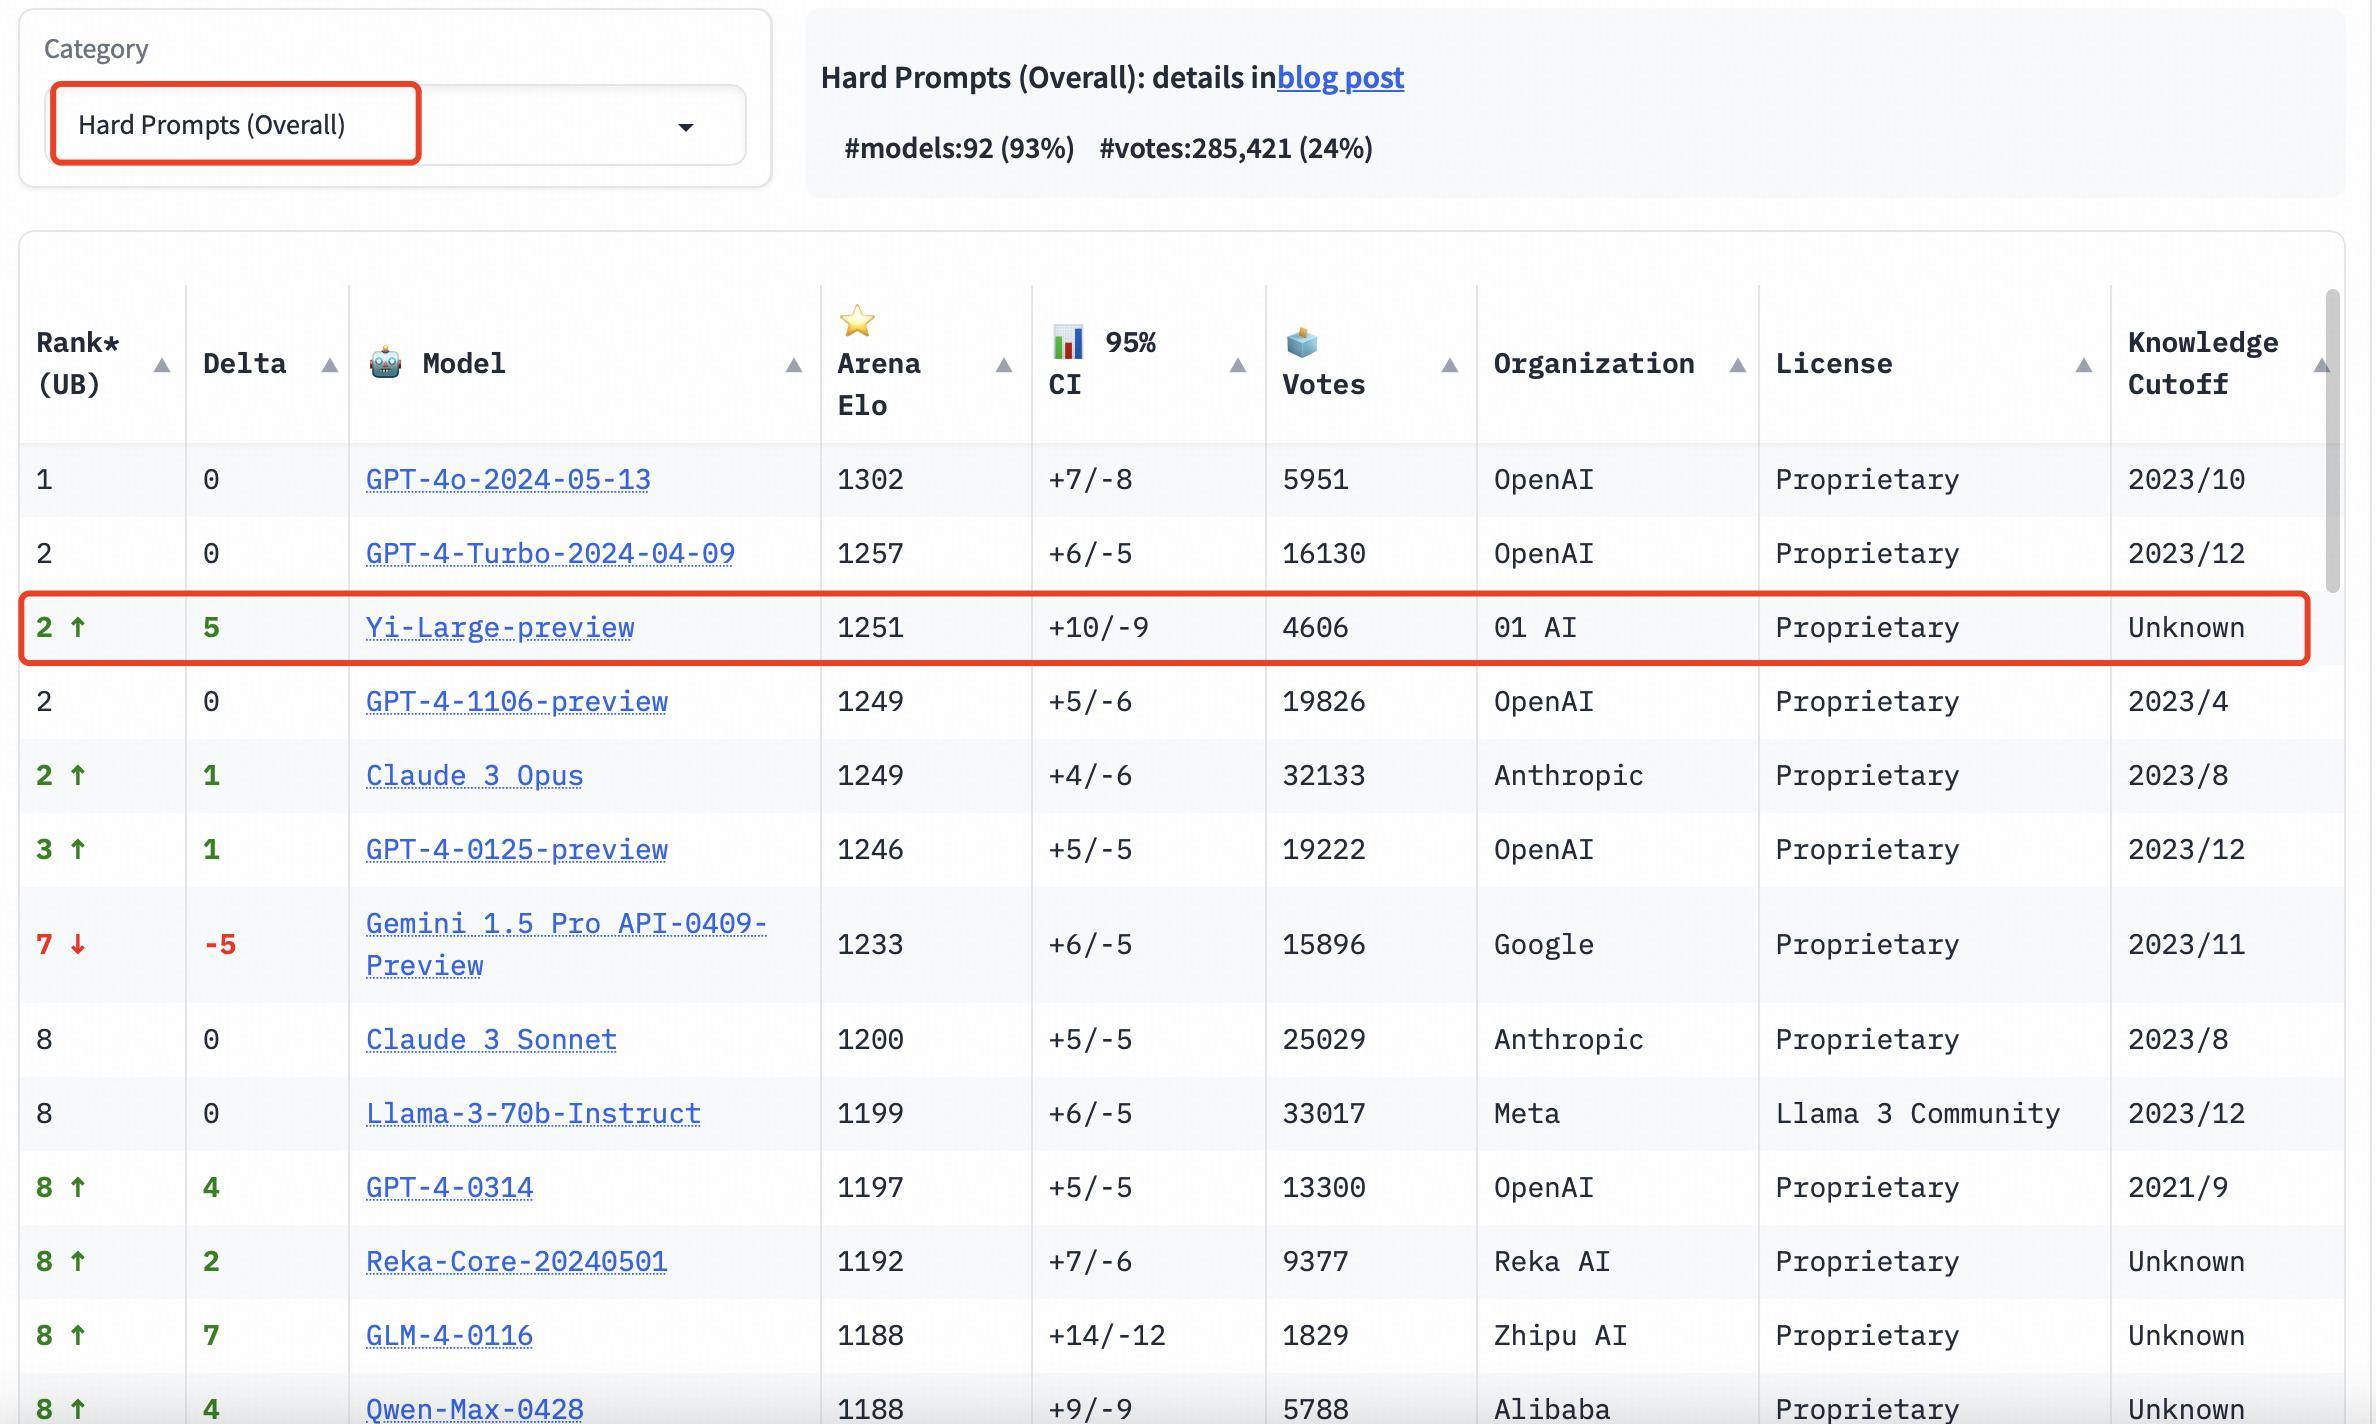
카테고리 순위에서는 Yi-Large도 좋은 성적을 거두었습니다. 프로그래밍 능력에 대한 세 가지 평가, 긴 질문 및 최신 "어려운 프롬프트 단어"는 LMSYS가 제공하는 대상 목록입니다. 그들은 전문성과 높은 난이도로 유명하며 대형 모델의 "가장 두뇌를 태우는" 공개 맹목이라고 할 수 있습니다. . 측정.
프로그래밍 능력에 대한 세 가지 평가, 긴 질문, 최신 "어려운 프롬프트 단어"는 전문적이고 어렵습니다. LMSYS 목록에서 "가장 두뇌를 소모하는" 공개 블라인드 테스트로도 알려져 있습니다.
프로그래밍 능력(코딩) 순위에서 Yi-Large의 Elo 점수는 Anthropic의 Claude 3 Opus를 능가하고 GPT-4o보다 낮으며 GPT-4-Turbo 및 GPT-4와 함께 2위를 차지합니다.
Longer Query 목록에서 Yi-Large는 GPT-4-Turbo, GPT-4 및 Claude 3 Opus와 공동으로 세계 2위를 차지했습니다.

Hard Prompts 목록에서 Yi-Large는 GPT-4-Turbo, GPT-4 및 Claude 3 Opus와 함께 공동 2위를 차지했습니다.
과학적인 방법을 사용하여 객관적인 결과를 얻으세요
대형 모델에 대한 객관적이고 공정한 평가를 어떻게 제공할 것인가는 항상 업계의 광범위한 관심사였습니다.
이전에도 업계에서는 다양한 '순위 휩쓸기' 방법이 있었지만 늘 대형 모델의 진정한 역량을 반영하지 못해 이해하려는 사람들은 안개에 휩싸였고, 관련 업계 투자자들은 머리를 긁적였다. .
LMSYS Org가 출시한 챗봇 아레나가 이러한 혼란을 깨기 시작합니다.
새로운 "아레나" 형식과 엄격한 테스트 팀을 통해 글로벌 업계에서 인정받는 벤치마크가 되었습니다. 심지어 OpenAI도 GPT-4o 공식 출시 전에 LMSYS에서 익명으로 사전 출시되고 사전 테스트되었습니다.
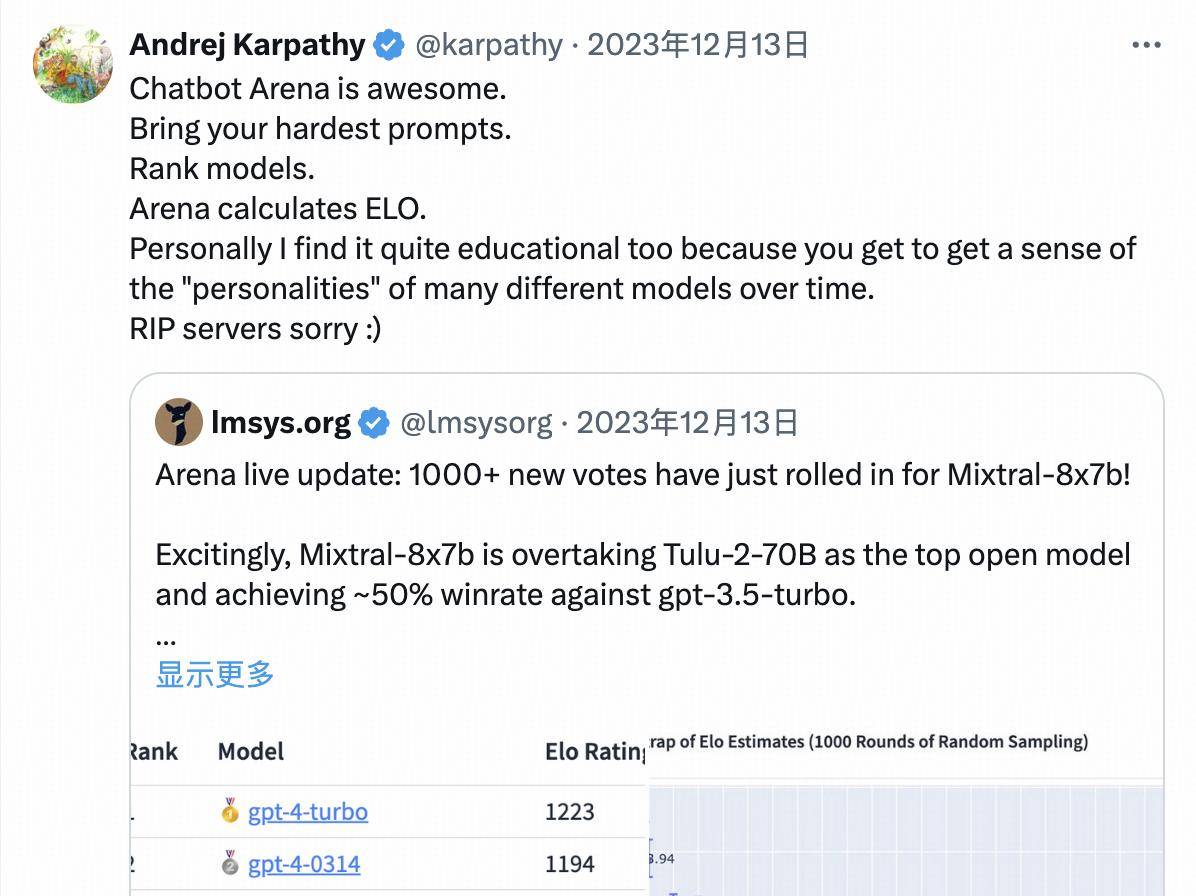
OpenAI의 창립 팀원인 Andrej Karpathy는 공개적으로 다음과 같이 말했습니다.
챗봇 아레나는 정말 멋지네요.
형태적인 측면에서 챗봇 아레나는 검색엔진 시대의 수평적 비교평가 사상을 차용하고 있습니다.
- 첫째, 평가를 위해 업로드된 모든 "입력" 모델은 무작위로 쌍을 이루고 익명 모델의 형태로 사용자에게 제공됩니다.
- 그런 다음 실제 사용자에게 자신만의 프롬프트 단어를 입력하도록 요청하고, 실제 사용자는 모델명을 알지 못한 채 두 모델 제품에 대한 답변을 평가하게 됩니다.
- 그런 다음 블라인드 테스트 플랫폼 https://arena.lmsys.org/에서 대형 모델을 쌍으로 비교하고 사용자가 대형 모델에 대한 질문을 독립적으로 입력합니다.
- 모델 A와 모델 B는 각각 양쪽에서 두 개의 PK 모델의 실제 결과를 생성합니다. 사용자는 결과 아래에서 4가지 중 하나를 선택하기 위해 투표할 수 있습니다. 모델 A가 더 좋음/모델 B가 더 좋음/둘 다 동률임/둘 다 좋지 않음
- 제출 후 다음 PK를 진행할 수 있습니다.
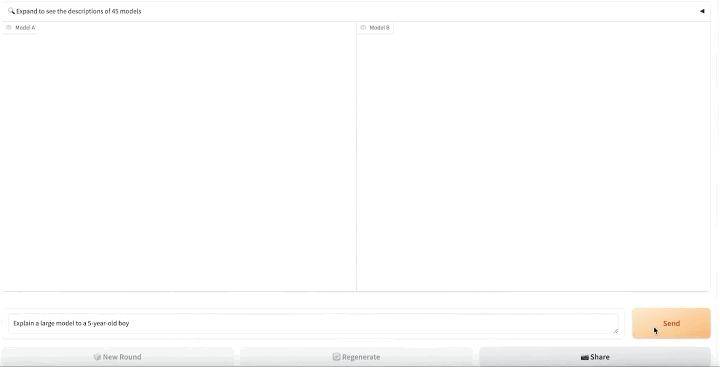
실제 사용자에게 크라우드 펀딩을 하여 온라인 실시간 블라인드 테스트와 익명 투표를 진행함으로써, 챗봇 아레나는 한편으로는 편견의 영향을 줄이고, 다른 한편으로는 테스트 세트에 따른 순위 지정 가능성을 최대한 방지합니다. 이로써 최종 결과의 객관성이 높아집니다.
Chatbot Arena는 또한 모든 사용자 투표 데이터를 정리하고 익명화한 후 공개합니다.
LMSYS Chatbot Arena는 실제 사용자 투표 데이터를 수집한 후 Elo 채점 시스템을 사용하여 모델의 성능을 정량화하고 채점 메커니즘을 더욱 최적화하며 참가자의 강점을 공정하게 반영하도록 노력할 것입니다.
Elo 채점 시스템에서는 각 참가자가 기본 점수를 받고, 각 게임이 끝난 후 게임 결과에 따라 참가자의 점수가 조정됩니다.
시스템은 참가자의 등급에 따라 게임에서 승리할 확률을 계산합니다. 점수가 낮은 플레이어가 점수가 높은 플레이어를 물리치면 점수가 낮은 플레이어가 더 많은 점수를 얻게 되며, 그 반대의 경우도 마찬가지입니다.
LMSYS 챗봇 아레나는 Elo 채점 시스템을 도입하여 순위의 객관성과 공정성을 상당 부분 보장합니다.
작은 것을 활용해 큰 승리를 거두세요
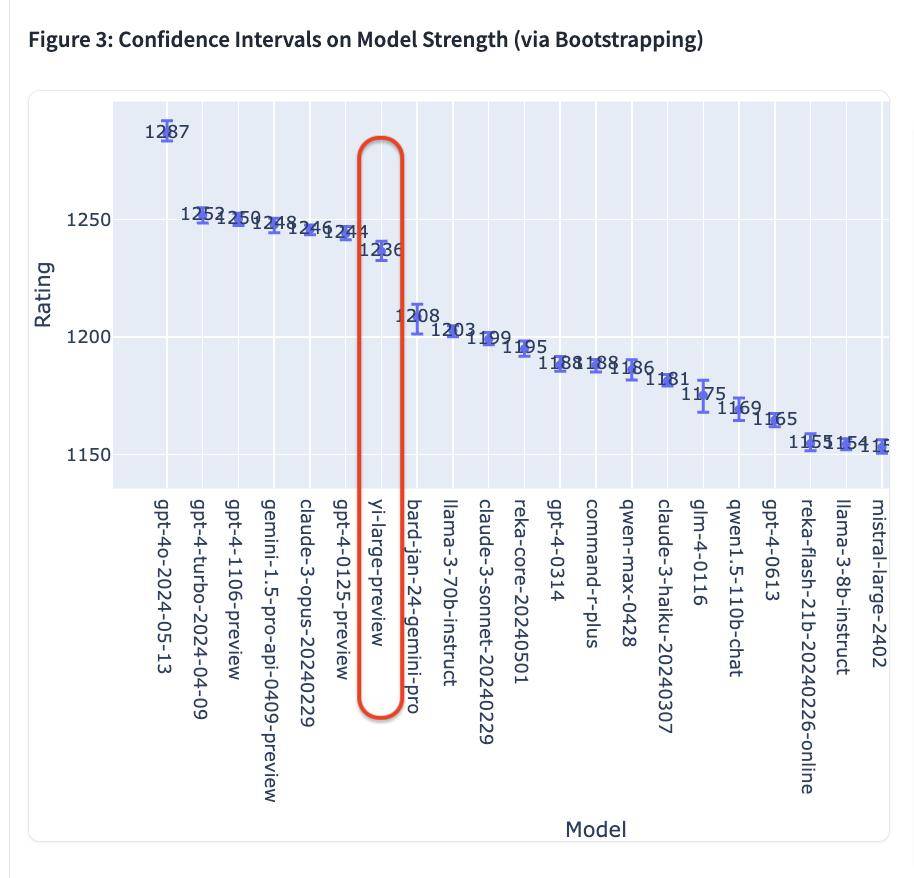
이번 챗봇 아레나에는 오픈소스 상위 모델인 Llama3-70B와 주요 제조사의 클로즈소스 모델을 포함해 총 44개 모델이 참가했습니다.
- 최신 Elo 점수를 보면 GPT-4o가 1287점으로 1위를 차지했습니다.
- GPT-4-Turbo, Gemini 1 5 Pro, Claude 3 0pus, Yi-Large 및 기타 모델은 약 1240점으로 두 번째 계층에 있습니다.
- 이후 Bard(Gemini Pro), Llama-3-70b-Instruct, Claude 3 Sonnet의 점수는 1200점 안팎으로 절벽으로 떨어졌습니다.
상위 6개 모델은 각각 해외 거대 기업인 OpenAI, Google, Anthropic에 속해 있으며, Zero-One Wansheng은 세계 4위에 속하며 GPT-4 및 Gemini 1.5 Pro와 같은 모델은 모두 1조 수준의 매개변수를 가지고 있습니다. 규모의 주력 모델이며 다른 모델도 수천억의 매개 변수 수준에 있습니다.
Yi-Large는 "큰 승리를 거두려면 작은 것이 필요합니다". 매개변수 수준이 1,000억에 불과하여 바짝 뒤따르고 있습니다.
AI 대형 모델의 경쟁적 발전은 여전히 치열한 단계에 있으며, '주', 심지어 '일'을 반복 단위로 사용하는 이 분야에서는 인공지능의 '수백 모델 대결'이 계속 펼쳐질 것이다. 특히 상대적으로 공정하고 객관적인 평가 시스템이 중요해졌습니다.
채점 시스템을 지속적으로 업데이트하는 평가 플랫폼은 업계 투자자가 기술 개발의 실제 현황을 볼 수 있을 뿐만 아니라 사용자에게 고급 모델을 선택할 권리를 부여하고 전체 대형 모델 산업의 건전한 발전을 촉진할 수 있습니다. .
자체 모델 역량의 반복이든 장기적인 평판의 관점에서든 대형 모델 제조업체는 실제 사용자 피드백과 전문적인 평가 메커니즘을 통해 제품을 입증하기 위해 Chatbot Arena와 같은 권위 있는 평가 플랫폼에 적극적으로 참여해야 합니다.
반대로, 순위 결과에만 신경쓰고 모델의 실제 적용 효과를 무시한다면, 모델 역량과 시장 수요의 격차는 더 커질 것이고, 결국 치열한 AI 속에서 발판을 마련하기 어려울 것입니다. 시장 경쟁.
AI 시대의 물결 속에서 주요 모델 제조사들이 탁월하거나 심지어 일류가 되고 싶다면 적어도 두 가지 자질이 필요하다.
- 나는 매일 세 번씩 나 자신을 성찰해야 한다. 발전을 통해 경험을 얻고, 경쟁을 통해 답을 얻는다.
- 진정한 금은 불을 두려워하지 않습니다. "야생 목록"에서 1위를 차지하기보다는 내면을 들여다보고 진정한 능력을 향상시키는 것이 좋습니다.
기대해볼 만한 점은 이제 현실적이고 혁신적이며 연구 개발에 있어서 국제 무대에서 업계 거대 기업과도 경쟁할 수 있는 우수한 국내 대형 모델 제조업체 그룹이 있다는 것입니다.
LMSYS 챗봇 아레나 블라인드 테스트 아레나 공개 투표 주소: https://arena.lmsys.org/
LMSYS 챗봇 리더보드 평가 순위(롤링 업데이트): https://chat.lmsys.org/?leaderboard
# aifaner 공식 WeChat 공개 계정: aifaner(WeChat ID: ifanr) 팔로우를 환영합니다. 더 흥미로운 콘텐츠가 최대한 빨리 제공될 예정입니다.
Ai Faner | 원본 링크 · 댓글 보기 · Sina Weibo