

방금 NVIDIA는 세계에서 가장 강력한 AI 칩을 출시했습니다.
생성적 AI(Generative AI)는 전환점에 도달했습니다.
2시간 동안 진행된 GTC 2024 컨퍼런스는 마치 대규모 콘서트에 가까웠고, 엔비디아 수석 과학자 짐 팬(Jim Fan)은 “젠슨 황이 새로운 테일러 스위프트다”라고 농담을 하기도 했다.
이것이 아마도 AI 업계에서 Nvidia의 Jen-Hsun Huang의 현재 위치일 것입니다.

작년에 황런순(Huang Renxun)은 AI의 'iPhone 순간'이 도래했다고 말하면서 일상생활이 AI에 의해 어떻게 다시 쓰여지고 있는지 확인할 수 있게 되었고, 오늘은 이러한 변화의 속도가 미친 듯이 가속화되고 있음을 보여줍니다.
지난 10년 동안 엔비디아는 무어의 법칙을 훨씬 뛰어넘는 약 100만 배에 달하는 AI 발전을 이루었습니다. 즉, 엔비디아는 자신만의 반복법칙을 작성하고 있는 것입니다. 칩 컴퓨팅 파워부터 AI 구현까지, 자동차 제조부터 의료 물류까지 엔비디아는 스스로 발전을 이루며 다양한 산업의 발전을 촉진해왔습니다.
무어의 법칙은 사라졌지만 NVIDIA는 새로운 무어의 법칙을 탄생시켰습니다.
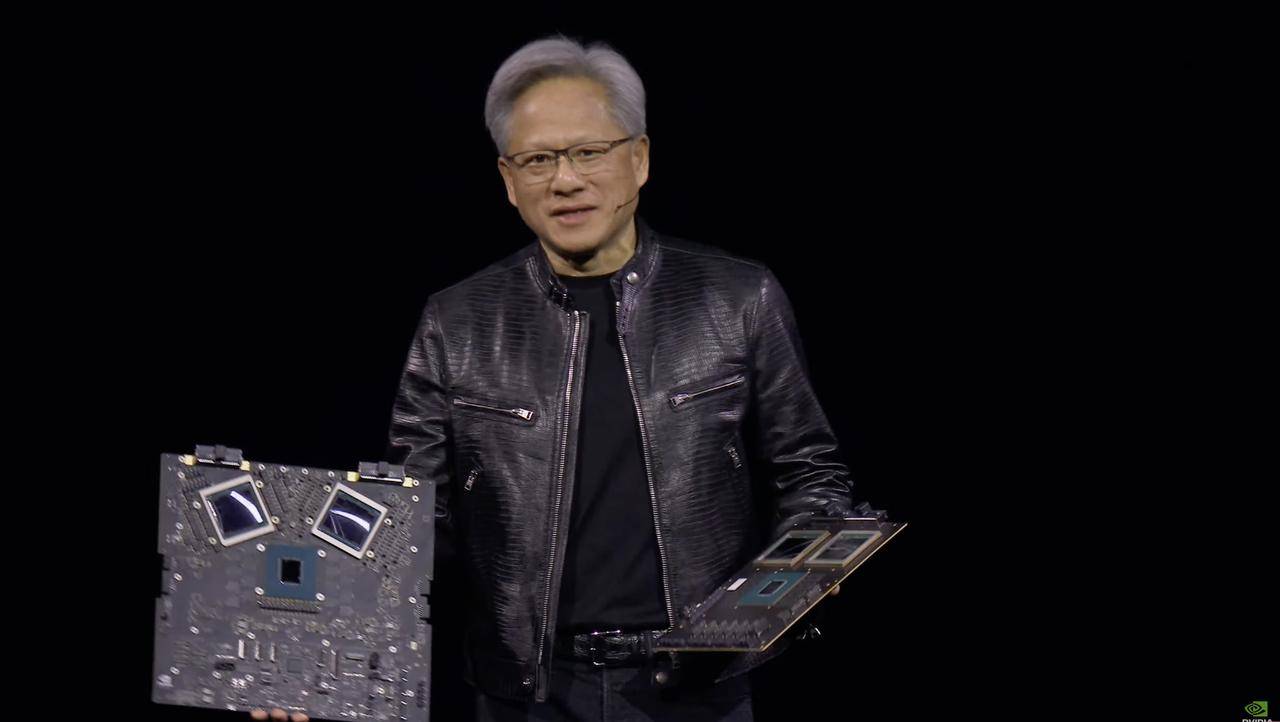
컴퓨터 그래픽 카드를 제외하면 NVIDIA는 평상시 우리에게 거의 인식되지 않지만, 우리 주변의 많은 제품의 기술적 진보는 항상 그것과 불가분의 관계에 있습니다. GTC 2024의 첫 번째 요약을 읽은 후에는 아마도 더 분명한 인식을 가질 수 있을 것입니다. AIGC의 물결.
OpenAI CEO Sam Altman이 어젯밤 X에서 보낸 트윗은 시대의 각주일 수 있습니다.
올해는 미래의 모든 해를 제외하면 인류 역사상 가장 흥미로운 해입니다.
올해는 인류 역사상 가장 흥미로운 해였지만, 앞으로는 가장 지루한 해가 될 것입니다.
세계에서 가장 강력한 AI 칩이 탄생하고 성능이 폭발적으로 향상됩니다.
이는 오늘날 세계에서 가장 발전된 GPU입니다.
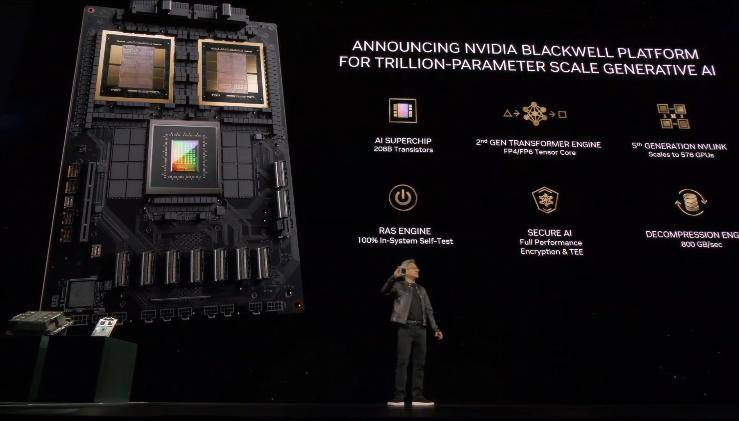
이번 컨퍼런스의 주인공은 AI 칩 'Blackwell B200'으로, 황런순(Huang Renxun)은 이 칩의 이름이 수학자이자 게임 이론가, 확률 이론가인 데이비드 블랙웰(David Blackwell)의 이름에서 따왔다고 말했다.
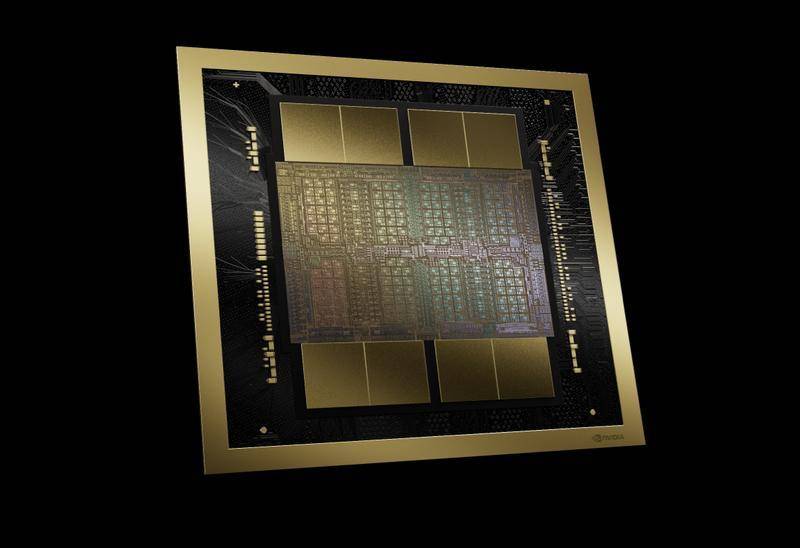
TSMC의 4NP 프로세스를 기반으로 하는 Blackwell 아키텍처의 컴퓨팅 칩에는 1,040억 개의 트랜지스터가 있습니다. 이는 이전 세대 GH100 GPU의 800억 개의 트랜지스터에 비해 또 다른 획기적인 발전입니다.

Blackwell B200은 전통적인 의미의 단일 GPU가 아닌 Blackwell GPU 2개 + Grace CPU 칩으로 구성되며 10TB/s NV-HBI(Nvidia High Bandwidth Interface)로 연결되어 각 칩이 단독으로 실행될 수 있도록 보장합니다. .
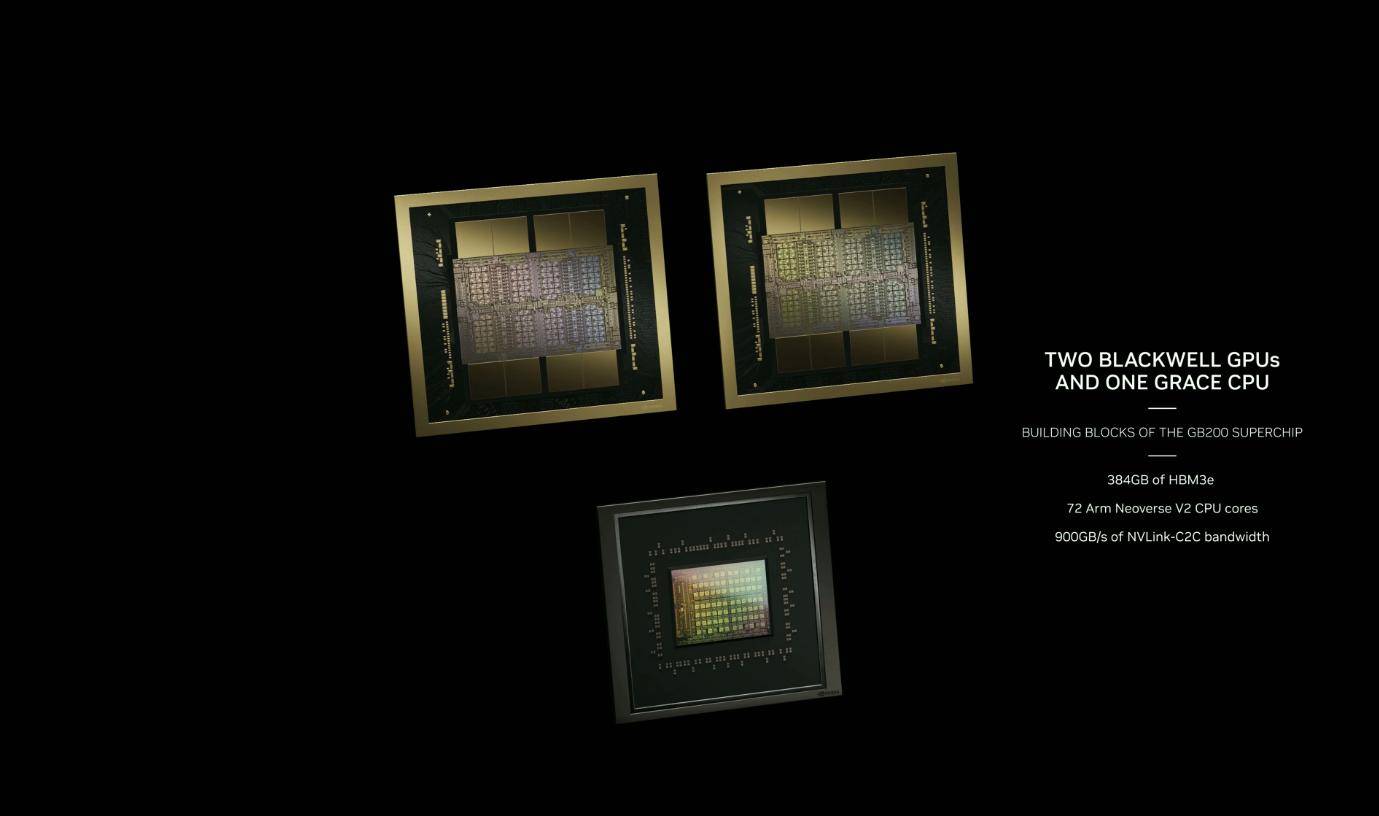
따라서 B200은 실제로 2,080억 개의 트랜지스터를 탑재해 최대 20페타플롭스의 FP4 컴퓨팅 파워를 제공할 수 있으며, 2개의 GPU를 하나의 Grace CPU와 결합하면 LLM(Large Language Model) 추론 작업 효율성을 30배까지 높일 수 있다.
GB200의 성능도 크게 향상될 예정이며, 1,750억 개의 매개변수를 사용하는 GPT-3 LLM 벤치마크에서 GB200의 성능은 H100의 7배, 훈련 속도는 H100의 4배입니다.
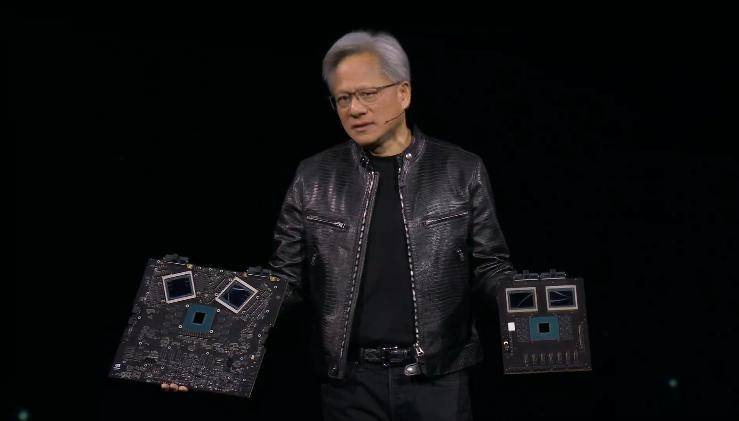
또한 H100에 비해 비용과 에너지 소비를 25배 절감합니다.
이전에는 엔비디아의 AI 프로세서 H100이 큰 인기를 끌었지만, H100 한 대당 최대 소비전력은 700와트에 달해 일반 미국 가정의 평균 소비전력을 훌쩍 뛰어넘었다. 소비는 미국의 대도시가 유럽의 일부 소규모 국가와 비슷하거나 그보다 더 클 것입니다.
Huang Renxun은 1조 8천억 개의 매개변수 모델을 훈련하려면 이전에는 8,000개의 Hopper GPU와 15MW의 전력이 필요했지만 이제는 2,000개의 Blackwell GPU가 단 4MW의 전력 소비만으로 이를 수행할 수 있다고 말했습니다.
Blackwell B200 GPU의 강력한 성능은 에너지 소비 측면에서도 완벽하게 반영될 수 있습니다. 최신 NVLink 인터커넥트 기술을 적용한 B200은 동일한 8GPU 아키텍처와 400GbE 네트워크 스위치를 지원해 성능이 대폭 향상되었으면서도 이전 세대 H100/H200과 동일한 최대 에너지 소비량(700W)을 달성할 수 있다.
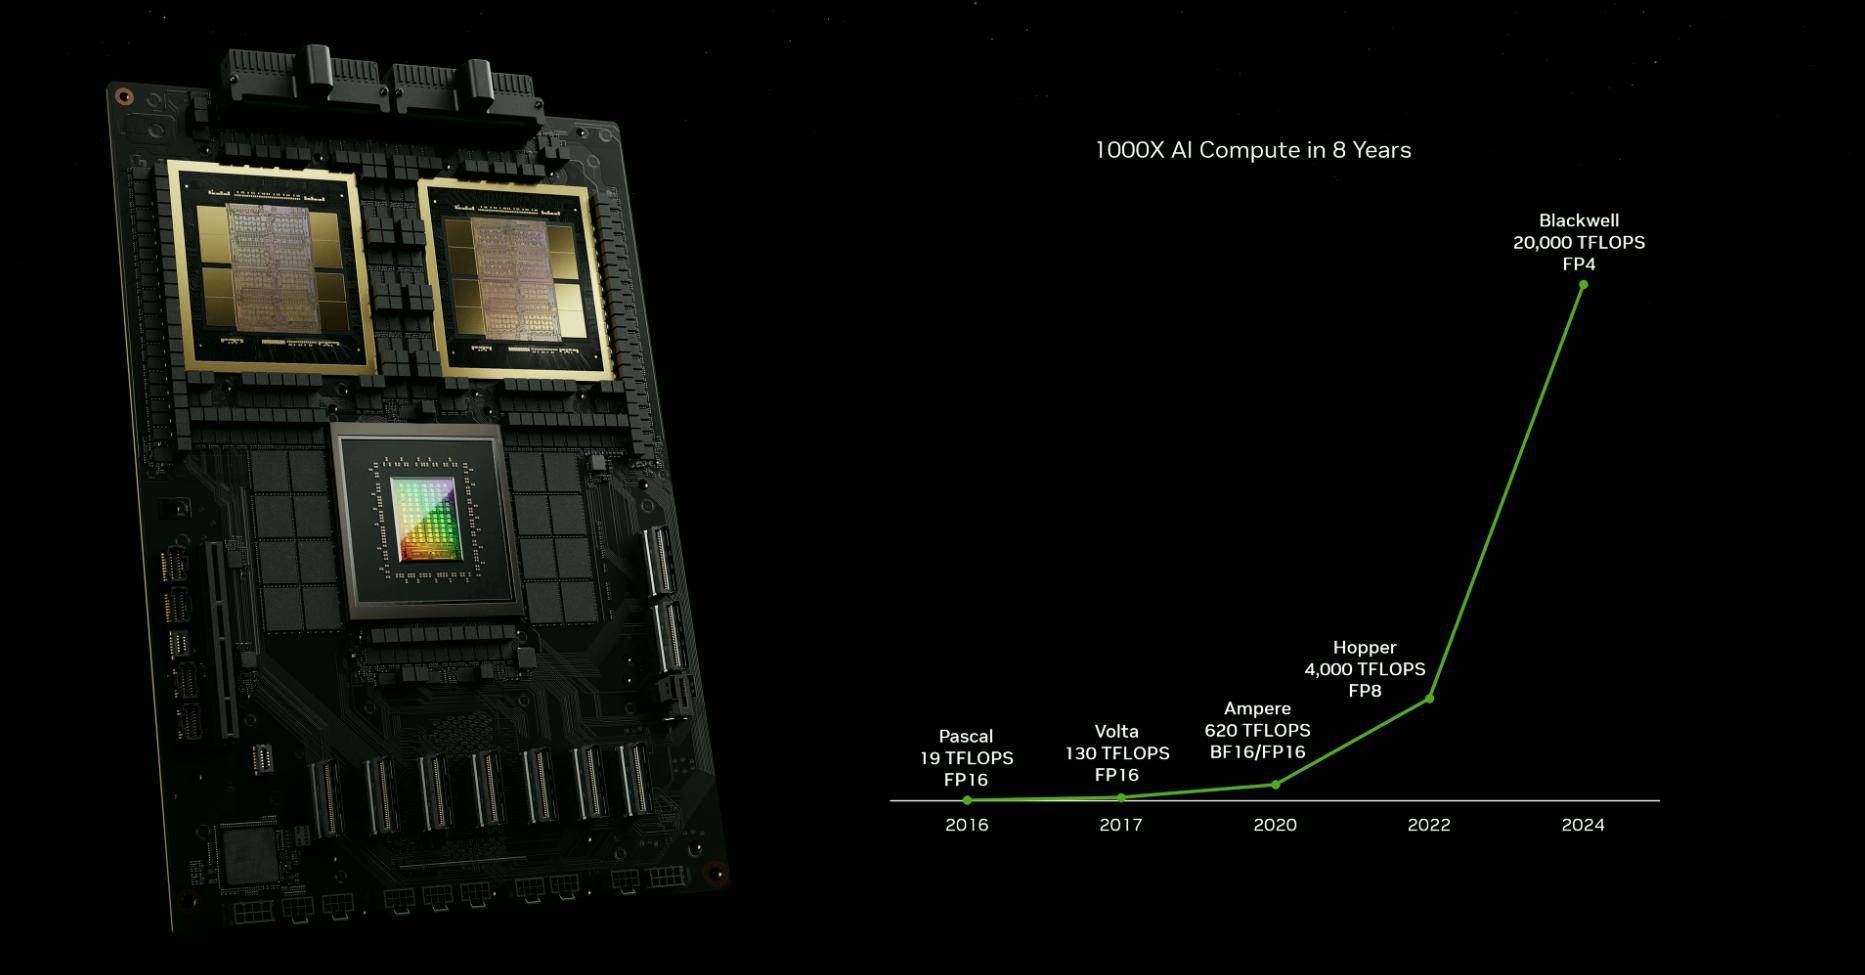
주목할만한 또 다른 점은 FP4의 컴퓨팅 성능입니다. 황런순(Huang Renxun)은 지난 8년 동안 AI 컴퓨팅 성능이 1000배나 증가했으며, 가장 중요한 개선 사항은 FP4 컴퓨팅 성능을 통해 컴퓨팅, 대역폭 및 모델 크기가 크게 향상된 2세대 Transformer 엔진이라고 말했습니다.
AI에서 일반적으로 사용되는 FP8 컴퓨팅 성능과 비교하여 B200의 두 컴퓨팅 칩은 H100의 2.5배 성능을 제공하며 Blackwell 아키텍처에서 각 칩의 컴퓨팅 성능은 이전 세대 Hopper 칩보다 25% 더 높습니다.
NVIDIA 수석 과학자 Jim Fan은 새로운 Blackwell B200 GPU를 "새로운 성능의 짐승"이라고 부릅니다.
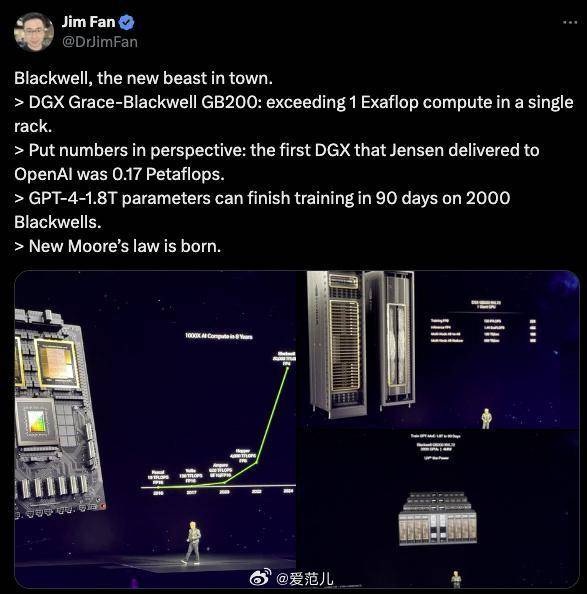
B200의 컴퓨팅 성능은 단일 아키텍처 내에서 1엑사플롭을 초과합니다. Jen-Hsun Huang이 OpenAI에 전달한 최초의 DGX의 성능은 0.17페타플롭스입니다. GPT-4-1.8T 매개변수는 90일 이내에 2,000개의 블랙웰 장치에서 훈련될 수 있습니다.
새로운 무어의 법칙이 탄생했다고 해도 과언이 아니다.
Blackwell은 여러 가지 변형으로 제공되므로 Nvidia는 세 가지 주요 옵션과 함께 전체 서버 노드에 대한 사양도 제공합니다.
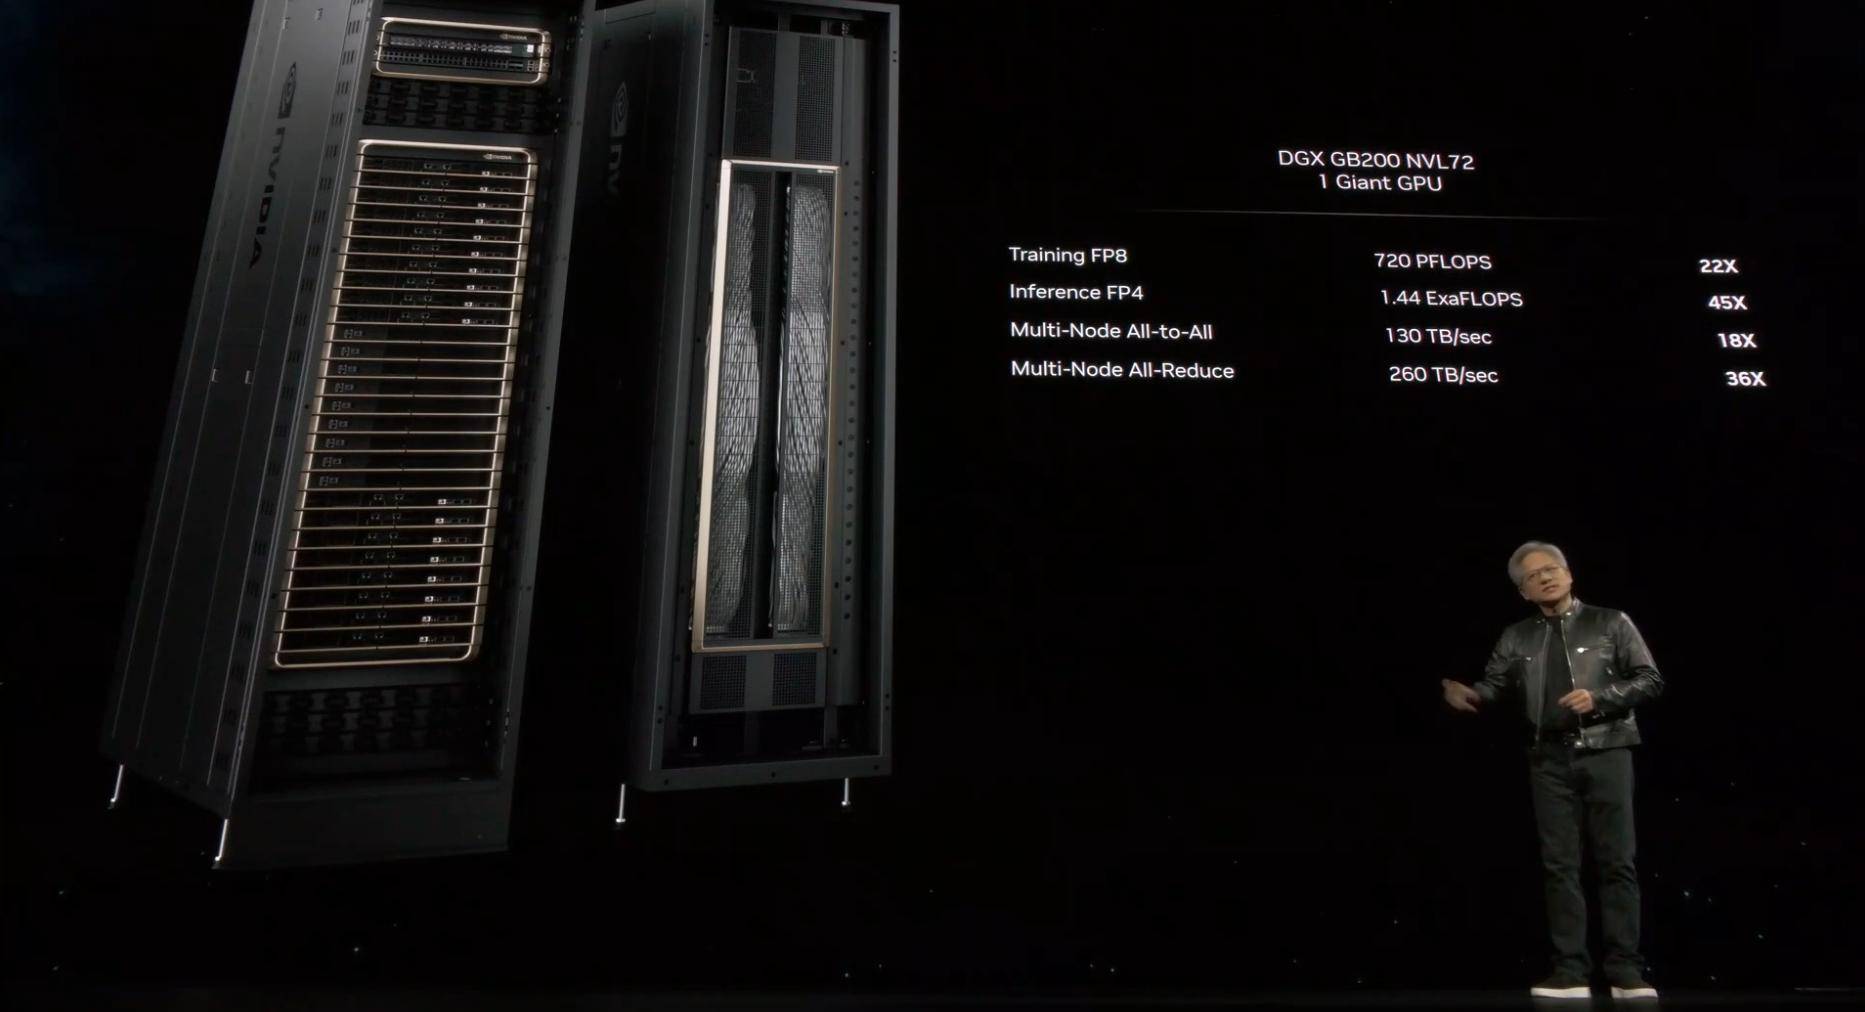
첫 번째는 가장 크고 가장 강력한 GB200 NVL72 시스템으로, 18개의 1U 서버로 구성되어 있으며 각 서버에는 2개의 GB200 슈퍼 칩이 장착되어 있습니다. 이 시스템은 72개의 B200 GPU로 1440 Peta FLOPS의 FP4 AI 추론 성능과 720 Peta FLOPS의 FP8 AI 훈련 성능을 제공하며 액체 냉각 솔루션을 채택할 예정이다. 하나의 NVL72는 27조 개의 매개변수 모델을 처리할 수 있다. 1조 7천억 개의 매개변수를 초과합니다.
또 다른 사양으로는 단일 서버 노드에서 B200 GPU 8개와 x86 CPU 1개를 사용하는 HGX B200이 있는데, 각 B200 GPU는 최대 1000W로 구성할 수 있으며 GPU는 최대 18페타플롭의 FP4 처리량을 제공하는데, 이는 속도가 더 느립니다. GB200의 GPU보다 10%.

마지막으로 NVIDIA는 HGX B200과 동일한 일반 사양을 갖고 x86 CPU와 8개의 B100 GPU를 탑재하지만 기존 HGX H100 인프라와 직접 호환되며 Blackwell GPU를 가장 빠르게 배포할 수 있는 HGX B100도 출시할 예정입니다. , 각각 GPU의 TDP는 700W로 제한됩니다.

이에 앞서 엔비디아는 H100, H200 등 AI 칩을 통해 아마존 등 선두 기업을 제치고 수조 달러 규모의 기업으로 성장했다.오늘 출시된 신형 블랙웰 B200 GPU와 GB200 '슈퍼칩'은 매우 유망하다. 선두를 달리고 심지어 애플을 능가하기도 합니다.
모든 것을 정의하는 소프트웨어 시대가 온다
2012년 소규모 연구자 그룹이 AlexNet이라는 획기적인 이미지 인식 시스템을 출시했는데, 이는 당시 개와 고양이를 분류하는 작업에 대한 이전 방법을 훨씬 능가하여 딥 러닝 및 컨볼루셔널 신경망 분야의 선두주자가 되었습니다. 이미지 인식에서 (CNN)의 잠재력.
Huang Renxun은 AI에서 기회를 본 후 AI에 모든 것을 걸기로 결정했습니다. 흥미로운 점은 예전에는 생성된 그림을 인식해 텍스트를 생성하는 데 사용됐지만 이제는 텍스트를 통해 그림을 생성한다는 점이다.
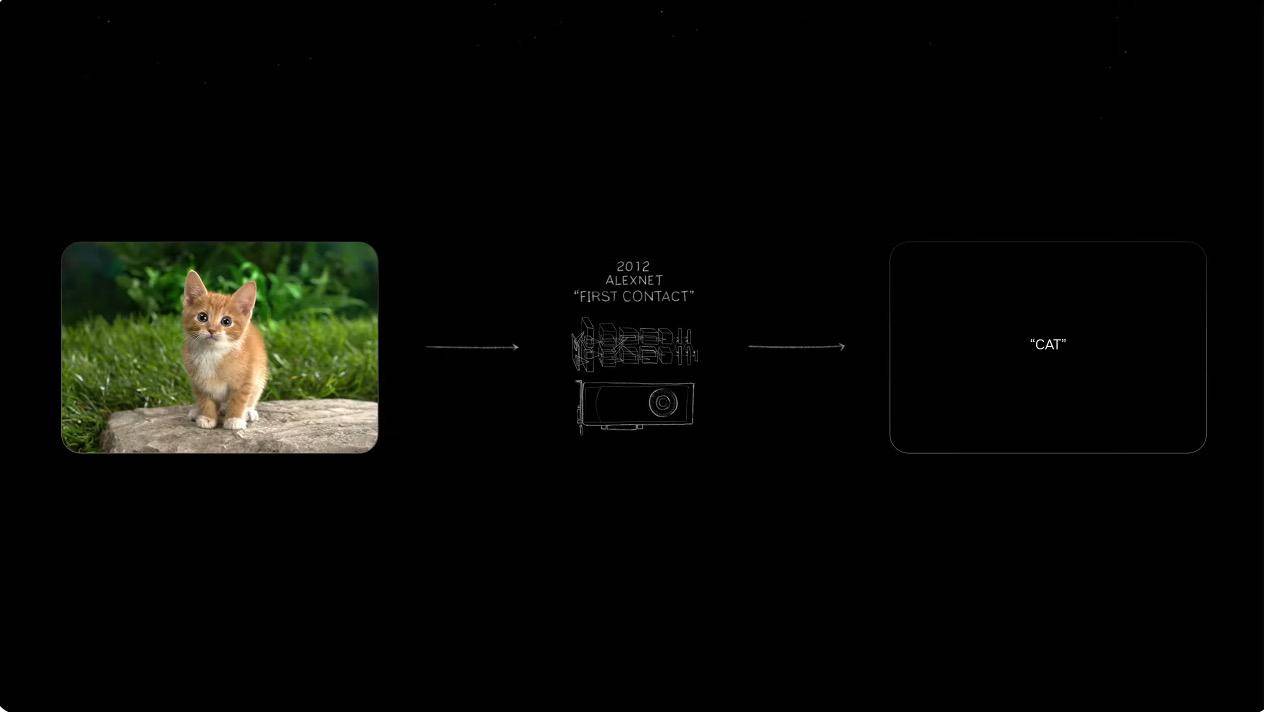
그렇다면 생성 AI의 물결이 도래하면 우리는 그것으로 무엇을 할 수 있을까요? Jen-Hsun Huang은 몇 가지 표준적인 답변을 제공했습니다.
NVIDIA의 기상 모델 Cordiff와 결합된 기존 기상 모델은 수백 또는 수천 킬로미터의 영역을 탐색하는 예측을 달성하여 태풍과 같은 다양한 영향을 제공함으로써 재산 손실을 최소화할 수 있습니다. Cordiff는 앞으로 더 많은 국가와 지역에 공개될 예정입니다.
생성적 AI는 디지털 기능을 통해 이미지와 오디오를 이해할 수 있을 뿐만 아니라 엄청난 컴퓨팅 성능을 사용하여 수십억 개의 화합물을 스캔하여 신약을 선별할 수도 있습니다.
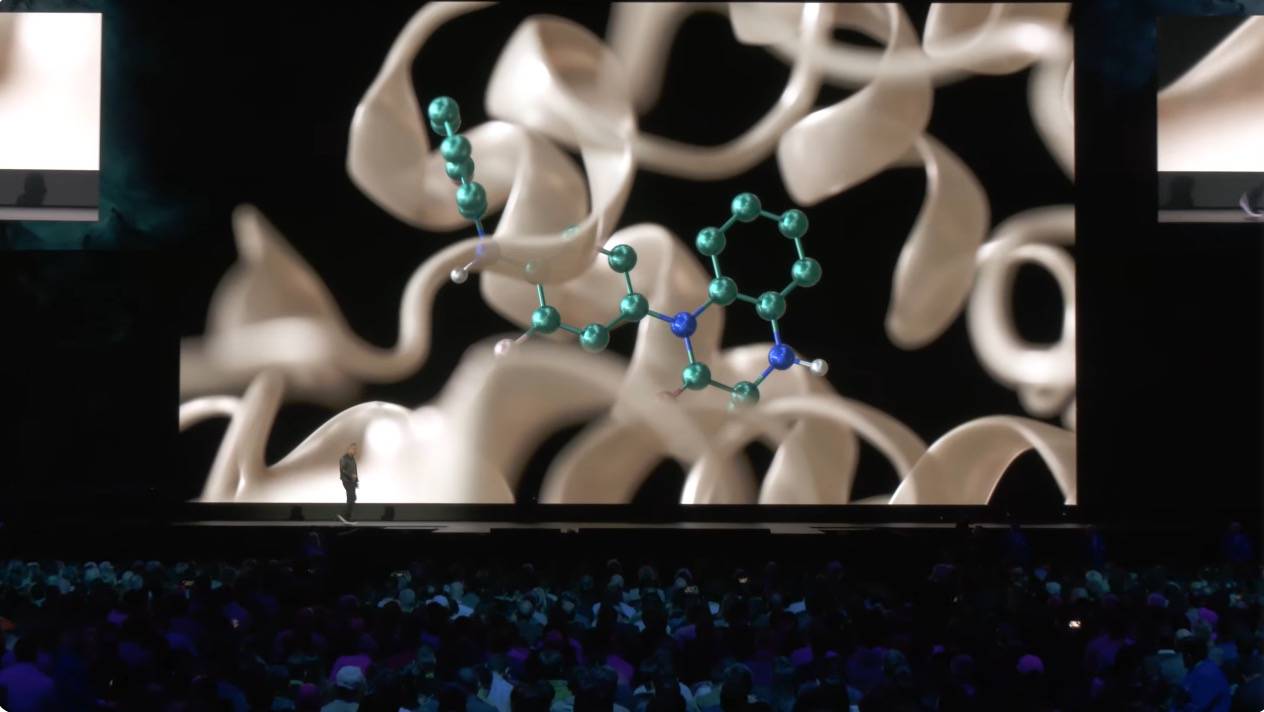
AI 무기 딜러인 Huang Renxun은 AI 칩 개발 지원을 전문으로 하는 NiMS 시스템도 도입했습니다. 미래에는 AI 슈퍼팀을 구성할 기회도 있을 수 있는데, 작업을 일련의 하위 작업으로 나눈 후 검색, 소프트웨어 최적화 등의 작업을 다양한 AI가 완료하도록 할 수 있습니다.
미래의 시설, 창고, 공장 건물은 소프트웨어로 정의될 것입니다.
휴머노이드 로봇, 자율 주행 자동차, 팔 조작 등 이러한 자율 로봇에는 소프트웨어 수준의 운영 체제가 필요합니다. 예를 들어 엔비디아는 AI와 옴니버스(Omniverse)의 결합을 통해 10만㎡ 규모의 로봇 창고를 구축했다.
물리적으로 정확한 시뮬레이션 환경에서는 천장에 장착된 100대의 카메라가 NVIDIA Metropolis 소프트웨어와 AMR(자율 이동 로봇)의 경로 계획 기능을 사용하여 창고의 모든 활동을 실시간으로 매핑합니다.
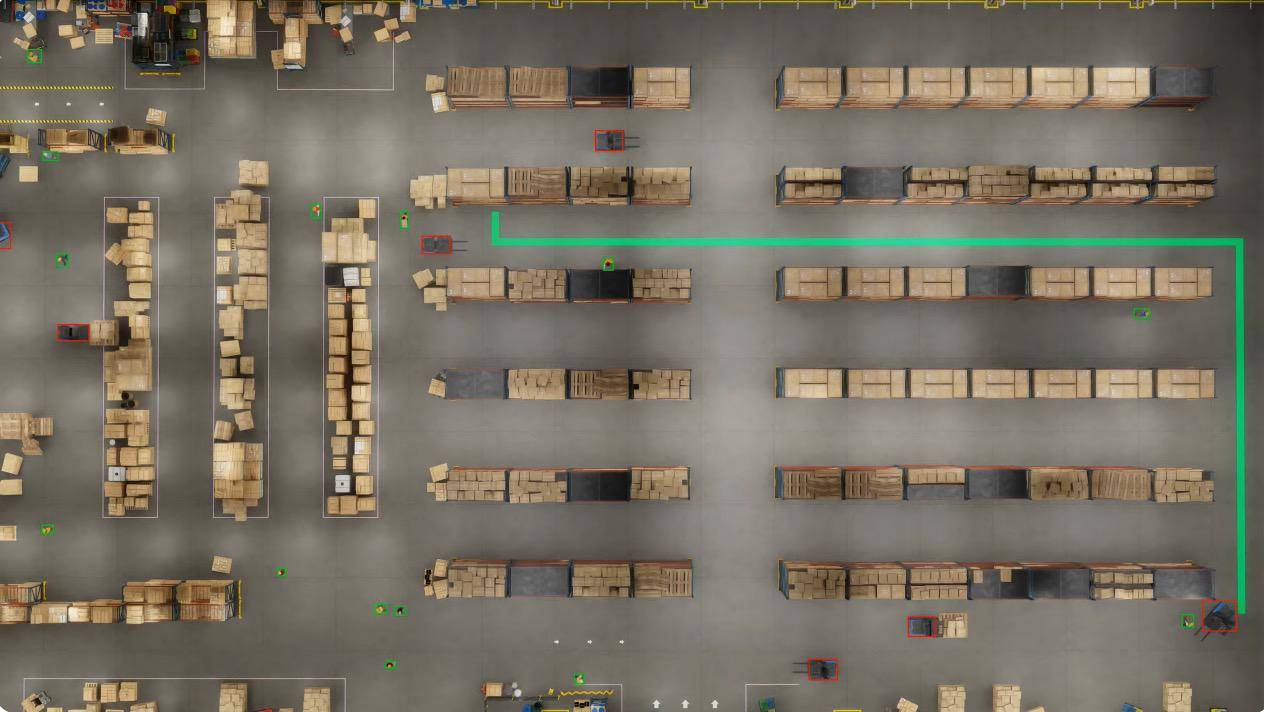
이러한 시뮬레이션에는 현실 세계의 예측 불가능성에 적응하는 시스템의 능력을 평가하고 최적화하기 위한 AI 에이전트의 소프트웨어 루프 테스트도 포함됩니다.
한 가지 시뮬레이션 시나리오에서 AMR은 팔레트를 픽업하기 위해 이동하던 중 의도한 경로를 차단하는 사고를 만났습니다. 그런 다음 Nvidia Metropolis는 실시간 점유 지도를 업데이트하고 제어 시스템에 전송하여 새로운 최적 경로를 계산했습니다.
창고 운영자는 자연어를 통해 시각적 모델에 질문할 수도 있으며, 모델은 세부 사항과 활동을 이해하고 즉각적인 피드백을 제공하여 운영 효율성을 향상시킬 수 있습니다.
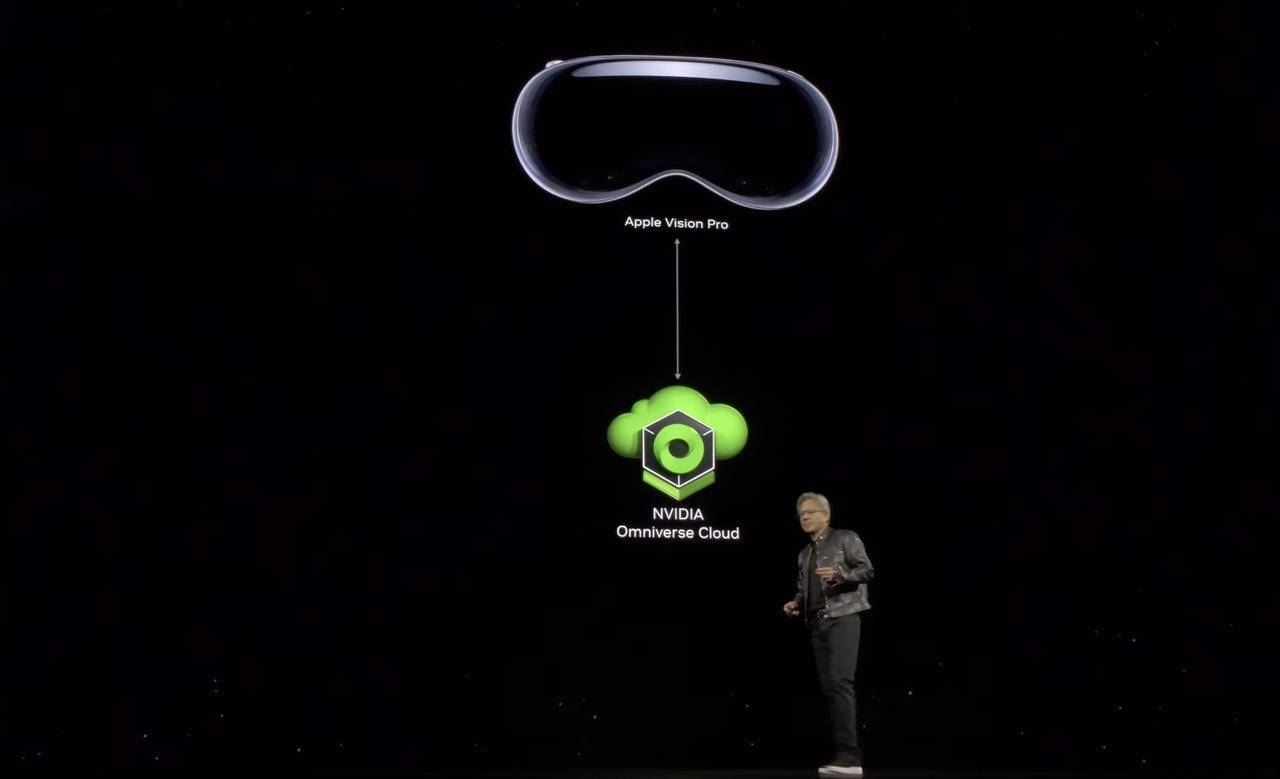
이번 컨퍼런스에는 애플 비전 프로(Apple Vision Pro)도 등장했다는 점은 주목할 만하다. 기업은 Omniverse Cloud를 통해 3D 애플리케이션의 대화형 범용 장면 설명(OpenUSD)을 실시간으로 Vision Pro로 쉽게 스트리밍하여 사용자가 이전과는 전혀 다른 방식으로 가상 세계를 탐색할 수 있도록 돕습니다.
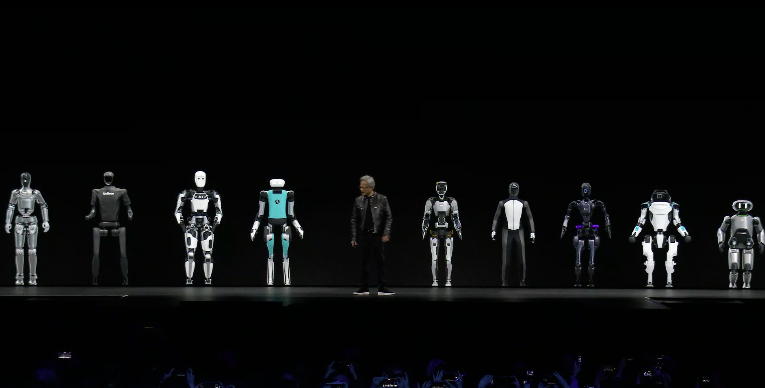
기자회견의 마지막은 친숙한 로봇 부문이었다. 황런쉰의 말처럼 그가 손을 펴고 다른 휴머노이드 로봇들과 함께 섰던 순간은 '컴퓨터 그래픽과 물리학, 인공지능의 교차점, 이것이다. .. 모든 것은 이 순간부터 시작된다.”
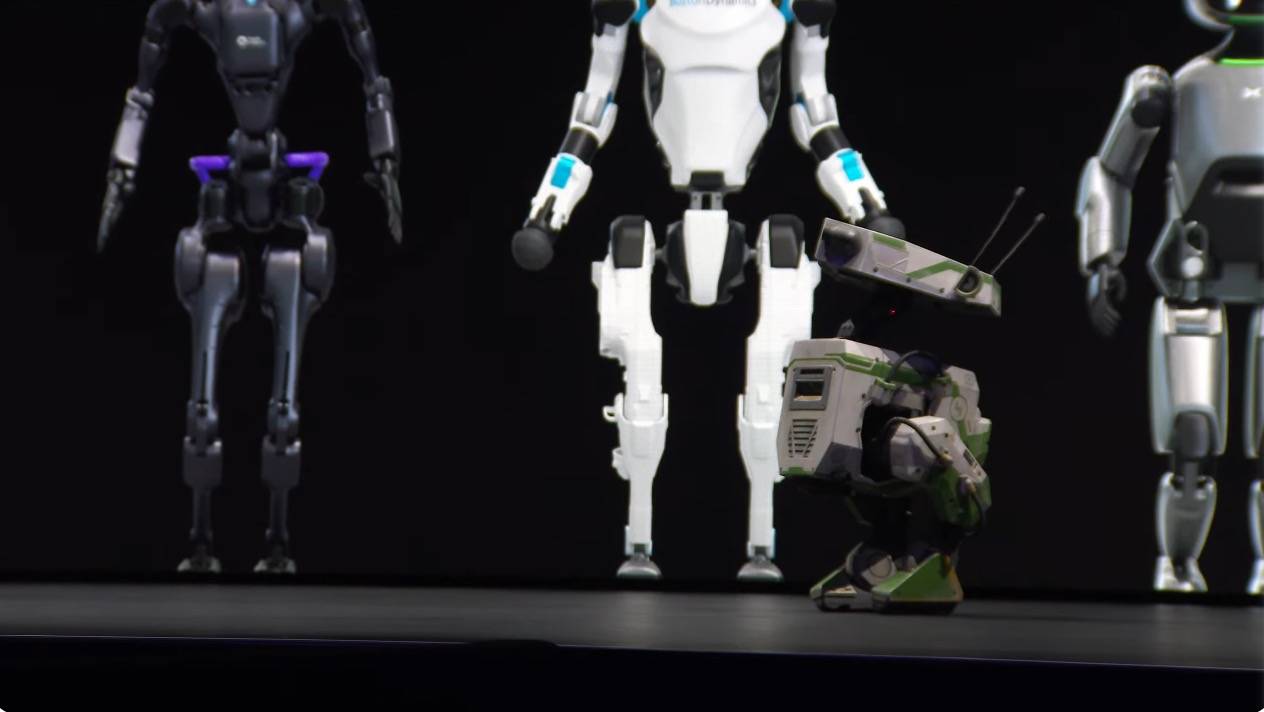
▲ 작은 부활절 달걀
10년 전 GTC에서 Jen-Hsun Huang은 처음으로 머신러닝의 중요성을 강조했는데, 많은 사람들이 여전히 엔비디아를 '게임 그래픽 카드' 제조사로 여겼지만 그들은 이미 AI 혁명의 선두에 있었습니다.
AI 애플리케이션의 원년으로 알려진 2024년에 NVIDIA는 이미 AI 소프트웨어와 하드웨어를 사용하여 대규모 언어 모델, 대화형 AI, 엣지 컴퓨팅, 빅데이터, 자율 주행, 생체 공학 로봇 등 다양한 분야의 다양한 산업에 힘을 실어왔습니다.
신약 발견은 우리의 전문 지식이 아니며, 컴퓨팅은 우리의 전문 지식이 아니며, 자동차를 만드는 것은 우리의 전문 지식이 아니며, 자동차를 만드는 데 필요한 AI 컴퓨터는 우리의 전문 지식입니다. 솔직히 회사가 이런 걸 다 잘하기는 힘들지만, 그 중 AI 컴퓨팅 부분은 우리가 아주 잘해요.
단일 업계의 선두주자에 비하면 엔비디아는 '막후의 빅맨'에 가깝다. AI를 거론하는 한 엔비디아는 피할 수 없는 화두임에 틀림없다.
황의 말대로 엔비디아는 이미 플랫폼 기업이다.
AI 시대 초 엔비디아가 AI 칩 시장 매출의 70% 이상을 점유할 수 있었던 것은 사전 배치와 역사적인 발전의 일반적인 추세였다. 회사 가치도 2조 달러를 넘었다. 오래전.
어쩌면 이것이 애플이 수년 간의 고군분투 끝에 자동차 제작을 포기하고 제너레이티브 AI에 막대한 투자를 한 이유이기도 할 것이다.경제적 이익이든 기술 동향이든 너무 도박할 가치가 있다.
우리가 여전히 "AI"의 유용성에 대해 의문을 품고 있는 상황에서, NVIDIA는 AI가 새로운 시대에 없어서는 안 될 부분이 되었음을 행동으로 입증했습니다.
저자: Li Chaofan, Xiao Fanbo, Mo Chongyu
# aifaner 공식 위챗 공개 계정: aifaner(WeChat ID: ifanr) 팔로우를 환영합니다. 더 흥미로운 콘텐츠를 최대한 빨리 제공해 드리겠습니다.
Ai Faner | 원본 링크 · 댓글 보기 · Sina Weibo