
별로 놀랄 일도 없이 Meta는 "역사상 가장 강력한 오픈 소스 대형 모델"로 알려진 Llama 3 시리즈 모델로 "거리를 폭파"시켰습니다.
특히 Meta는 8B와 70B라는 서로 다른 크기의 두 가지 모델을 오픈 소스로 공개했습니다.
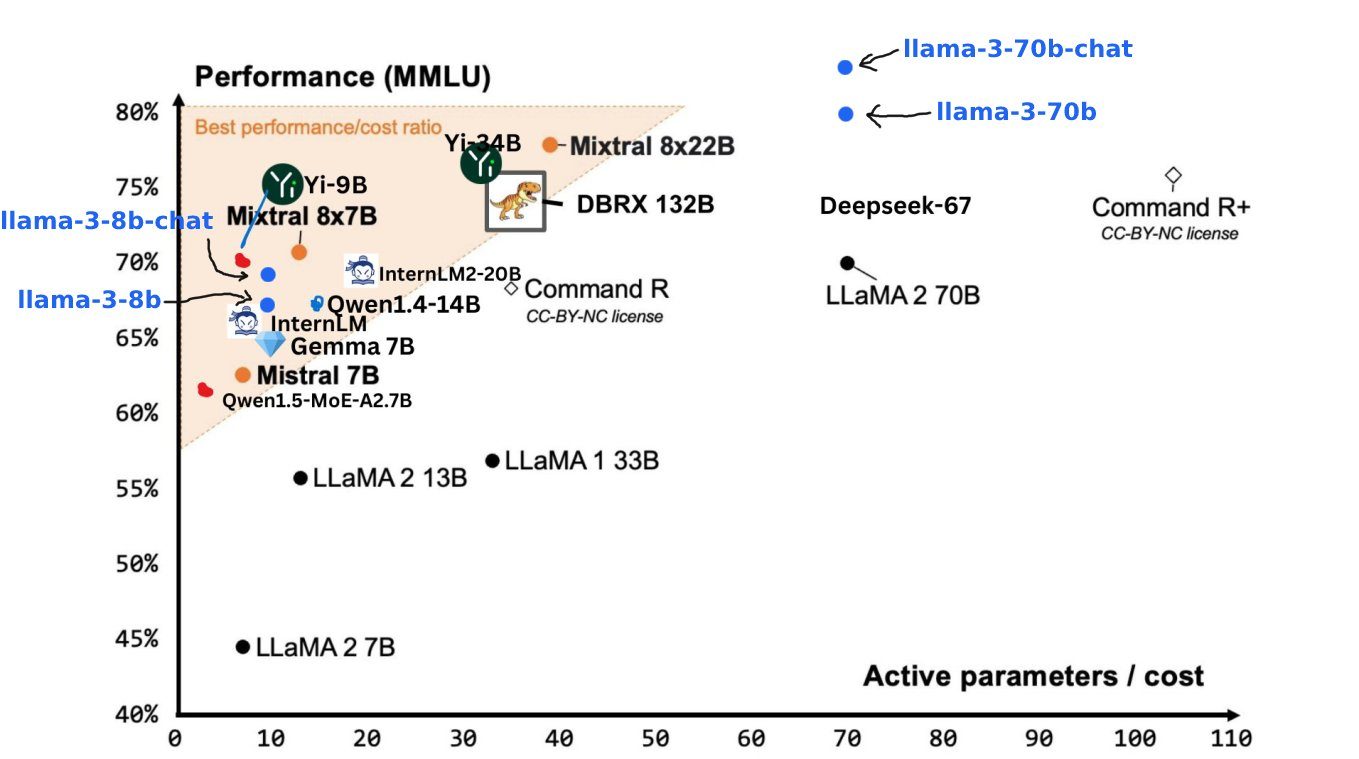
- Llama 3 8B: 기본적으로 가장 큰 Llama 2 70B만큼 강력합니다.
- Llama 3 70B: Gemini 1.5 Pro와 비교할 수 있는 첫 번째 레벨 AI 모델로 모든 측면에서 Claude Big Cup을 능가합니다.
위의 내용은 메타의 전채요리일 뿐, 실제 식사는 아직 나오지 않았습니다. 앞으로 몇 달 안에 Meta는 다중 모드, 다중 언어 대화, 더 긴 컨텍스트 창 및 기타 기능을 갖춘 일련의 새로운 모델을 연속적으로 출시할 예정입니다. 그중 400B가 넘는 헤비급 플레이어는 Claude 3 Super Cup과 경쟁할 것으로 예상됩니다. .
라마 3 체험 주소 : https://llama.meta.com/llama3/
또 다른 GPT-4 레벨 모델이 여기에 있습니다. Llama 3이 열려 있습니다.
이전 라마2 모델과 비교하면 라마3는 새로운 차원에 도달했다고 할 수 있다.
Pre-training과 Post-training의 개선 덕분에 이번에 출시된 pre-training과 Instruction Fine-tuning 모델은 오늘날 8B 및 70B 매개변수 스케일에서 가장 강력한 모델이며 동시에 post의 최적화도 이루어졌습니다. – 훈련 과정을 통해 모델의 오류율이 크게 감소하고 모델의 일관성이 향상되었으며 응답의 다양성이 풍부해졌습니다.
Zuckerberg는 공개 연설에서 사용자가 WhatsApp에서 Meta AI 코딩 관련 질문을 하지 않는다는 점을 고려하면 이 분야에서 Llama 2의 최적화가 뛰어나지 않다고 밝혔습니다.
이번에 Llama 3는 추론, 코드 생성 및 지침 따르기 측면에서 획기적인 개선을 이루어 더욱 유연하고 사용하기 쉬워졌습니다.
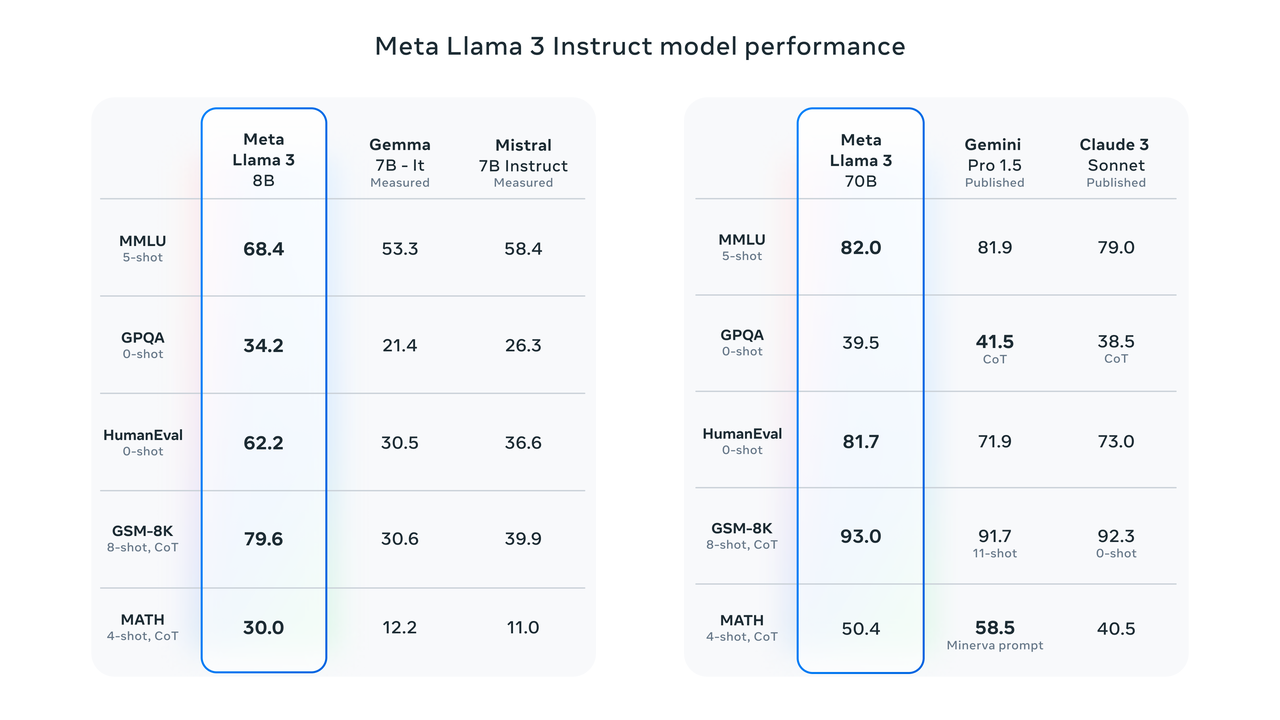
벤치마크 테스트 결과에 따르면 Llama 3 8B는 MMLU, GPQA, HumanEval 및 기타 테스트에서 Google Gemma 7B 및 Mistral 7B Instruct보다 훨씬 높은 점수를 받았습니다. Zuckerberg의 말에 따르면 가장 작은 Llama 3은 기본적으로 가장 큰 Llama 2만큼 강력합니다.
Llama 3 70B는 최고의 AI 모델 중 하나입니다. 전반적인 성능은 Claude 3보다 우수합니다. Gemini 1.5 Pro와 비교하면 균등하게 일치합니다.
벤치마크에서 모델 성능을 정확하게 연구하기 위해 Meta는 새로운 고품질 인간 평가 데이터세트도 개발했습니다.
평가 세트에는 조언 요청, 브레인스토밍, 분류, 비공개 Q&A, 코딩, 창의적 글쓰기, 추출, 페르소나, 공개 Q&A, 추론, 재작성 및 요약 등 12가지 주요 사용 사례를 다루는 1800개의 프롬프트가 포함되어 있습니다.

Llama 3가 이 평가 세트에 과적합되는 것을 방지하기 위해 Meta는 연구팀이 이 데이터 세트에 액세스하는 것을 금지했습니다. 클로드 소네트(Claude Sonnet), 미스트랄 미디엄(Mistral Medium), GPT-3.5와의 1대1 대결에서 메타라마 70B가 '압도적인 승리'로 대회를 마무리했다.
Meta 공식 소개에 따르면 Llama 3는 모델 아키텍처에서 상대적으로 표준적인 순수 디코더 Transformer 아키텍처를 선택했습니다. Llama 2와 비교하여 Llama 3에는 몇 가지 주요 개선 사항이 있습니다.
- Llama 3는 128K 토큰 어휘가 포함된 토크나이저를 사용하여 언어를 보다 효율적으로 인코딩하여 모델 성능을 크게 향상시킵니다.
- Llama 3 모델의 추론 효율성을 향상시키기 위해 8B 및 70B 모델 모두에서 GQA(Grouped query attention)가 사용됩니다.
- 이 모델은 self-attention이 문서 경계를 넘지 않도록 마스크를 사용하여 8192개 토큰 시퀀스에 대해 훈련되었습니다.
훈련 데이터의 양과 질은 다음 단계에서 대규모 모델 역량의 출현을 촉진하는 핵심 요소입니다.
Meta Llama 3는 처음부터 가장 강력한 모델이 되도록 설계되었습니다. Meta는 사전 훈련 데이터에 많은 투자를 합니다. 라마 3는 공개 소스에서 수집한 15T 이상의 토큰을 사용하는 것으로 알려졌는데, 이는 라마 2가 사용한 데이터 세트의 7배에 해당하며, 여기에 포함된 코드 데이터는 라마 2의 4배에 달합니다.

다국어의 실제 적용을 고려하면 Llama 3 사전 학습 데이터 세트의 5% 이상이 30개 이상의 언어를 포괄하는 고품질 비영어 데이터로 구성되어 있지만 Meta 관계자도 영어에 비해 성능이 떨어진다고 인정했습니다. 이들 언어 중 약간 열등할 것으로 예상됩니다.
Llama 3가 최고 품질의 데이터로 학습될 수 있도록 Meta 연구팀은 휴리스틱 필터, NSFW 필터, 의미 중복 제거 방법 및 텍스트 분류기를 사용하여 데이터 품질을 사전에 예측합니다.
연구팀은 또한 이전 세대의 Llama 모델이 고품질 데이터를 식별하는 데 놀라울 정도로 뛰어나다는 사실을 발견하여 Llama 2가 Llama 3에서 지원하는 텍스트 품질 분류기에 대한 훈련 데이터를 생성하도록 하여 "AI 훈련 AI"를 진정으로 실현했다는 점에 주목할 필요가 있습니다. " .
훈련의 질 외에도 Llama 3는 훈련 효율성에서도 비약적인 발전을 이루었습니다.
Meta는 가장 큰 Llama 3 모델을 훈련하기 위해 데이터 병렬화, 모델 병렬화, 파이프라인 병렬화라는 세 가지 유형의 병렬화를 결합했다고 밝혔습니다.
16K GPU에서 동시에 훈련할 때 GPU당 400TFLOPS 이상의 컴퓨팅 활용도를 달성할 수 있습니다. 연구팀은 맞춤형으로 구축된 24K GPU 클러스터 2개에서 훈련을 실행했습니다.
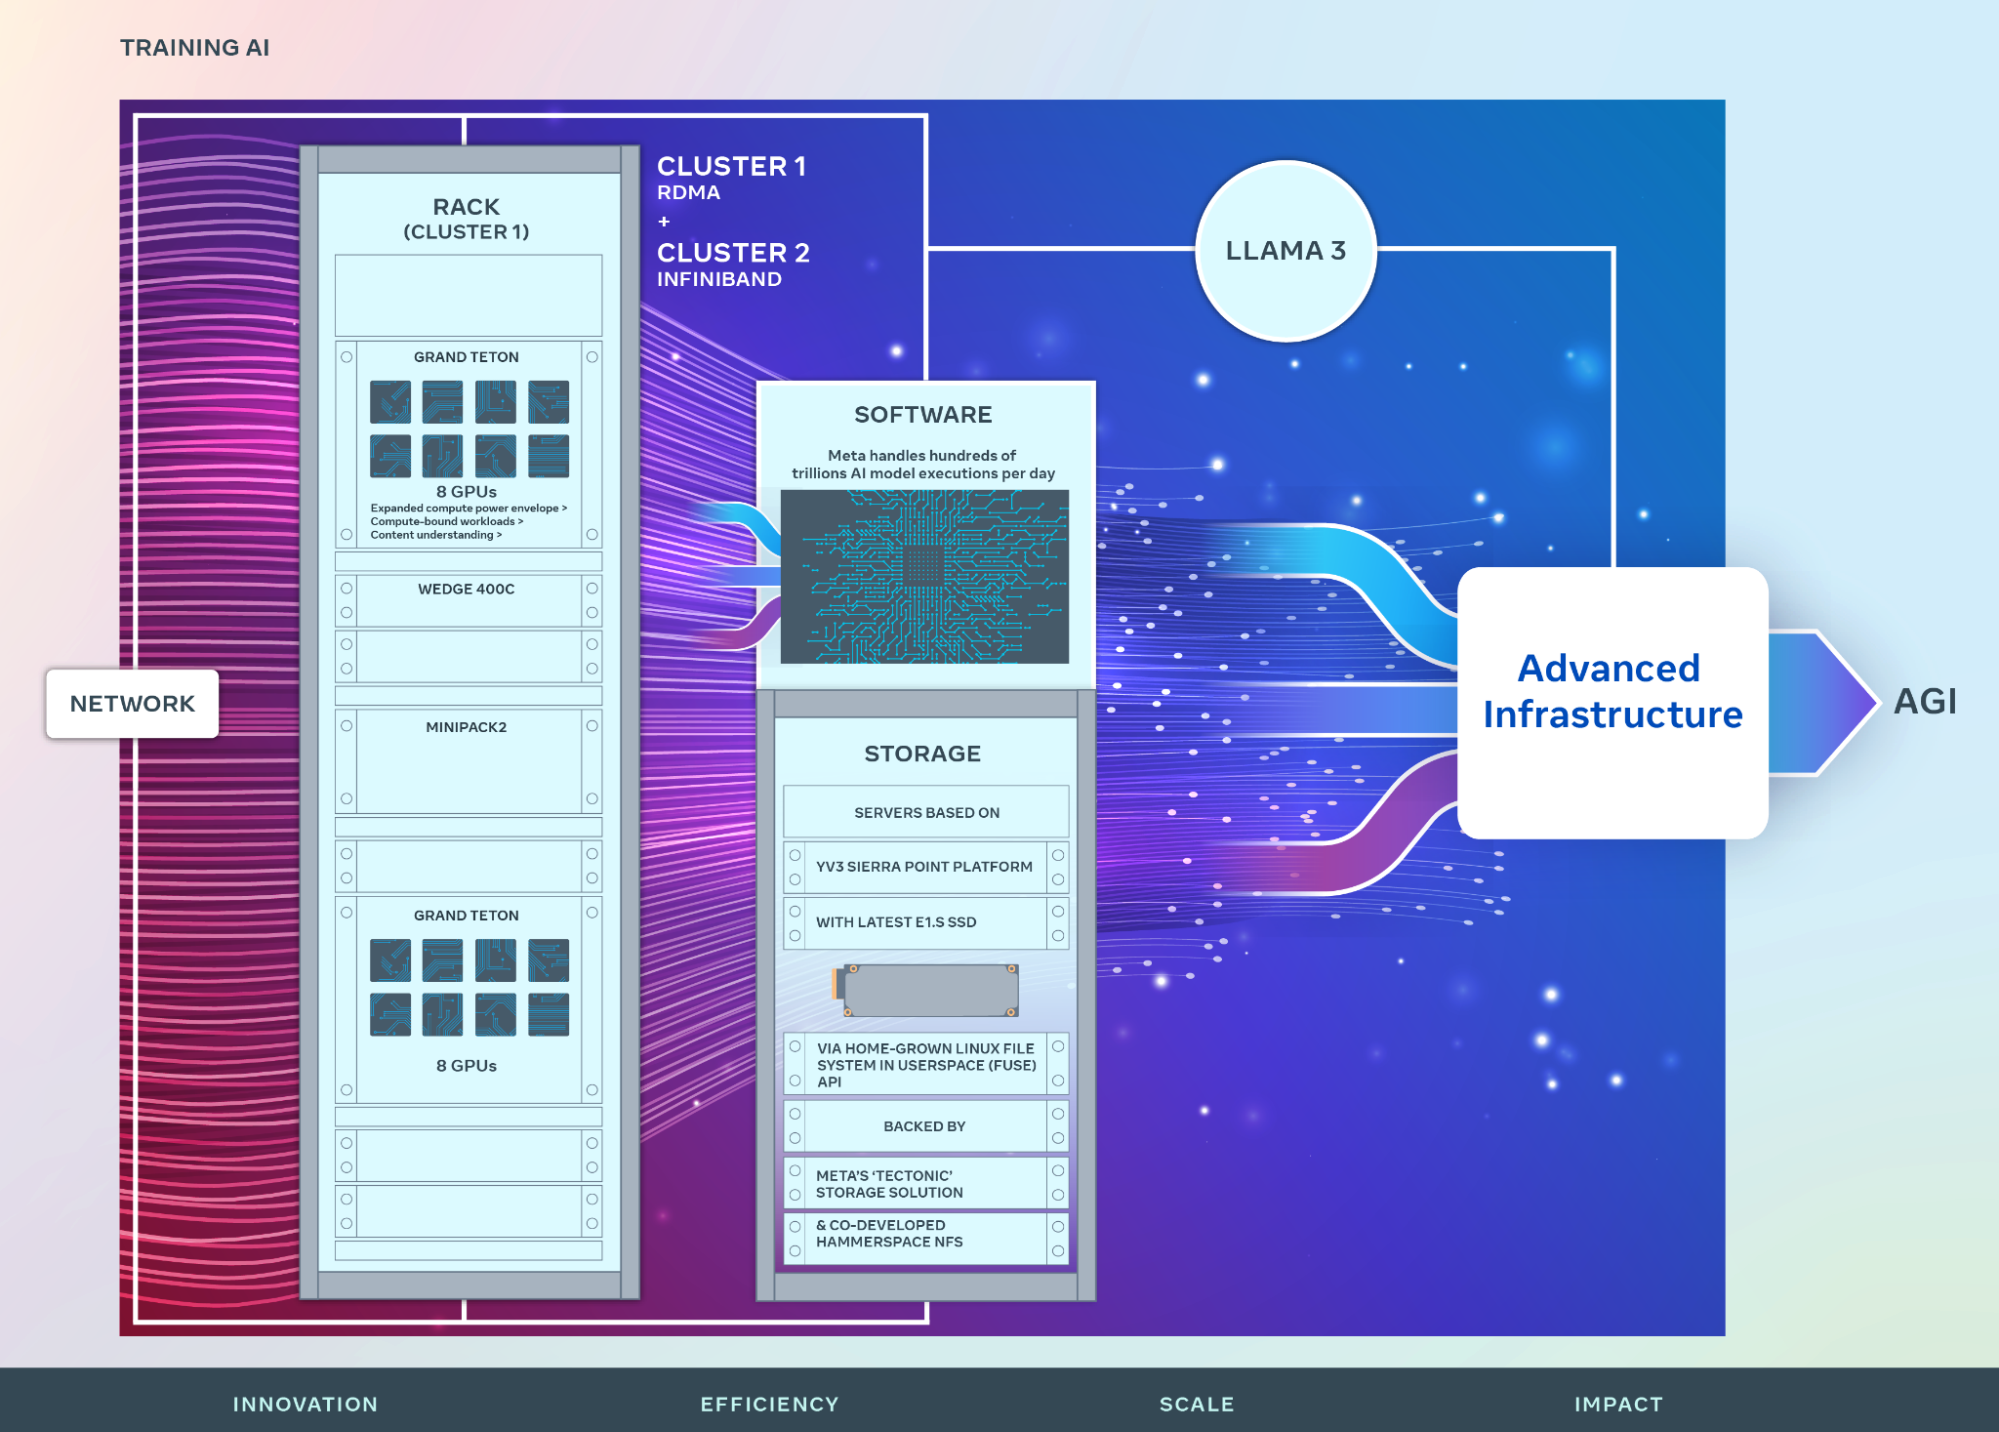
GPU 가동 시간을 극대화하기 위해 연구팀은 오류 감지, 처리 및 유지 관리를 자동화하는 새로운 고급 학습 스택을 개발했습니다. 또한 Meta는 하드웨어 안정성과 자동 데이터 손상 감지 메커니즘을 크게 개선했으며 체크포인트 및 롤백의 오버헤드를 줄이기 위해 확장 가능한 새로운 스토리지 시스템을 개발했습니다.
이러한 개선으로 전체 유효 훈련 시간이 95% 이상 증가했으며, Llama 3의 훈련 효율성도 이전 세대보다 약 3배 높아졌습니다.
더 자세한 기술적 내용은 Meta의 공식 블로그(https://ai.meta.com/blog/meta-llama-3/)를 확인하세요.
오픈 소스 VS 폐쇄 소스
라마3는 메타의 '아들'로서 AI 챗봇 메타 AI에 자연스럽게 통합된다.
저커버그는 지난해 메타커넥트 2023 컨퍼런스를 계기로 이번 회의에서 메타AI 출시를 공식 발표한 뒤 빠르게 미국, 호주, 캐나다, 싱가포르, 남아프리카공화국 등 지역에 홍보했다.
이전 인터뷰에서 주커버그는 라마 3가 탑재된 메타 AI에 대해 “사람들이 무료로 사용할 수 있는 가장 지능적인 AI 비서가 될 것”이라며 더욱 자신감을 보였다.
제 생각에는 이것이 챗봇과 같은 형식에서 질문만 하면 답변을 주고, 더 복잡한 작업을 주면 해당 작업을 완료할 수 있는 형식으로 바뀔 것이라고 생각합니다.
첨부된 Meta AI 웹 체험 주소는 https://www.meta.ai/ 입니다.
물론, Meta AI가 "해당 국가/지역에서 아직 제공되지 않는" 경우 오픈 소스 모델을 사용하기 위한 가장 간단한 채널인 세계 최대 AI 오픈 소스 커뮤니티 웹사이트인 Hugging Face를 사용할 수 있습니다.
체험 주소 첨부 : https://huggingface.co/meta-llama/Meta-Llama-3-70B-Instruct
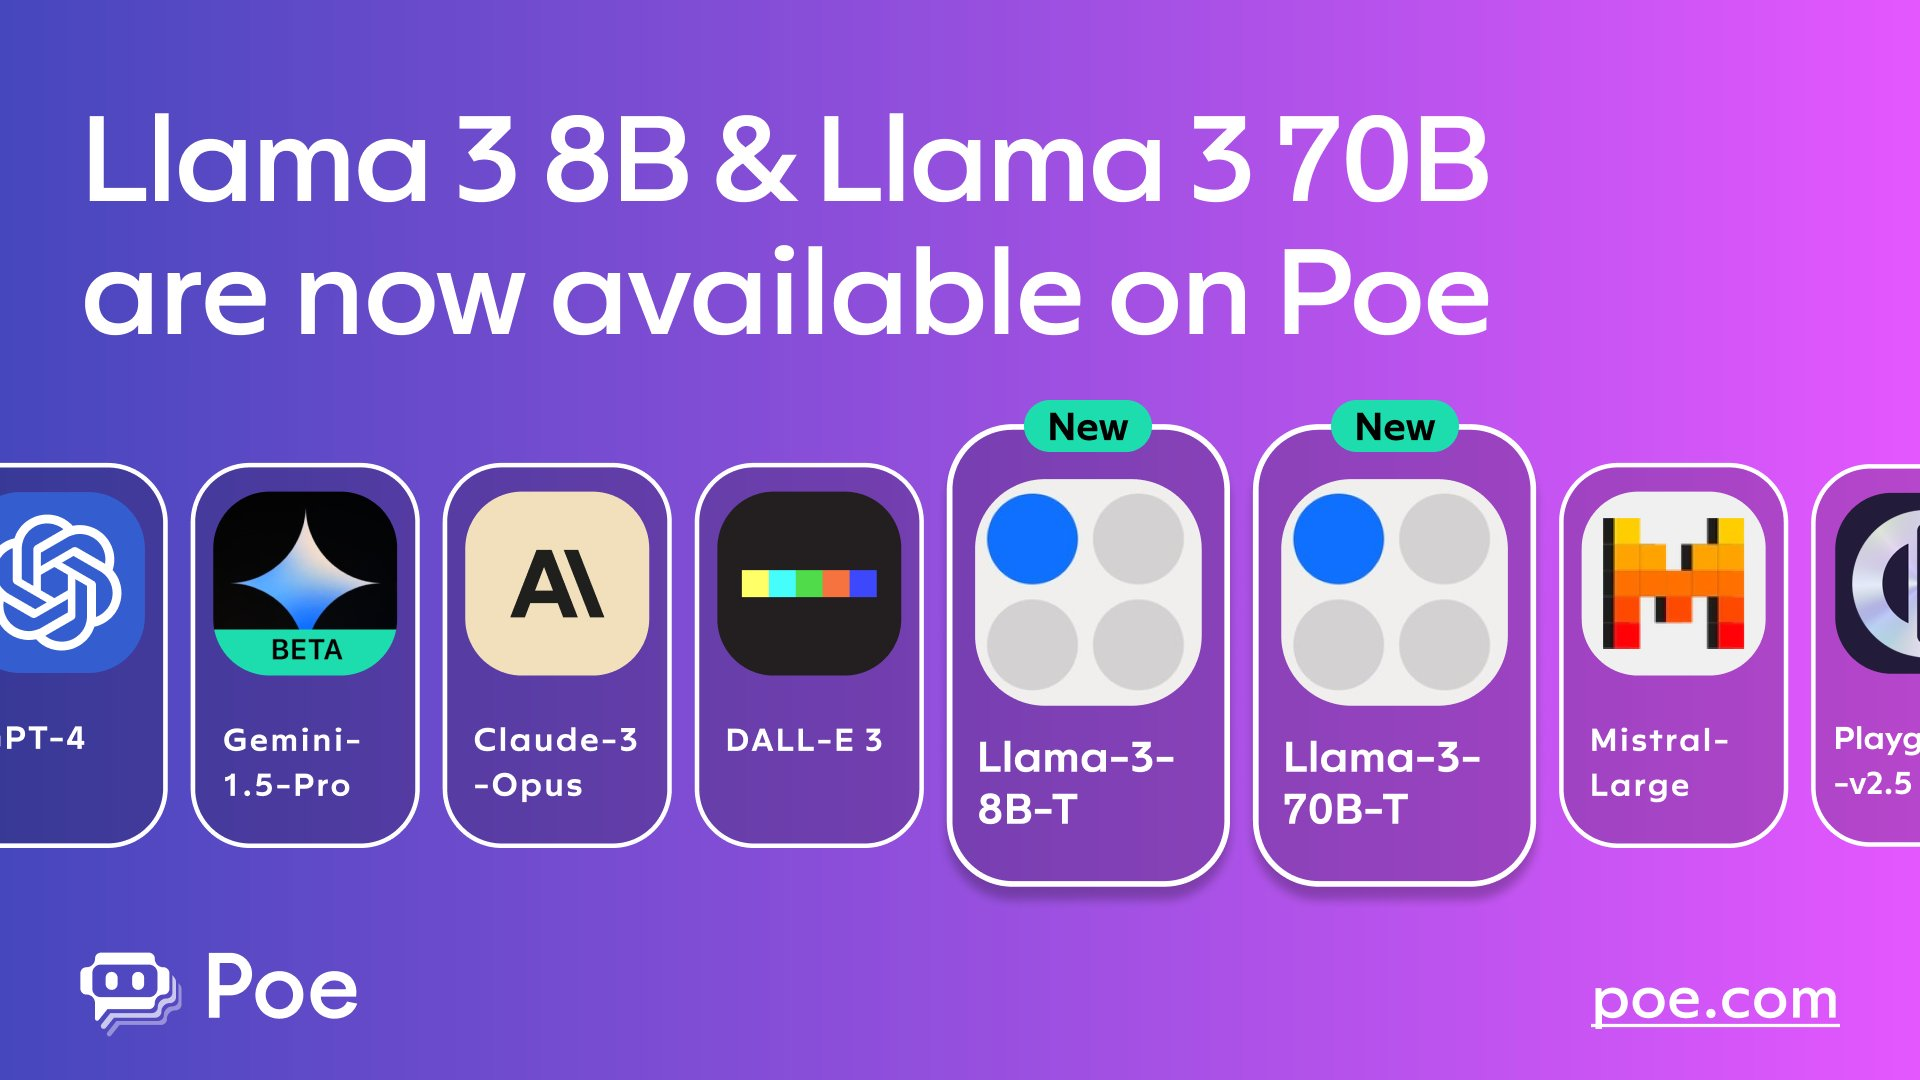
Perplexity, Poe 및 기타 플랫폼도 Llama 3를 플랫폼 서비스에 통합한다고 빠르게 발표했습니다.
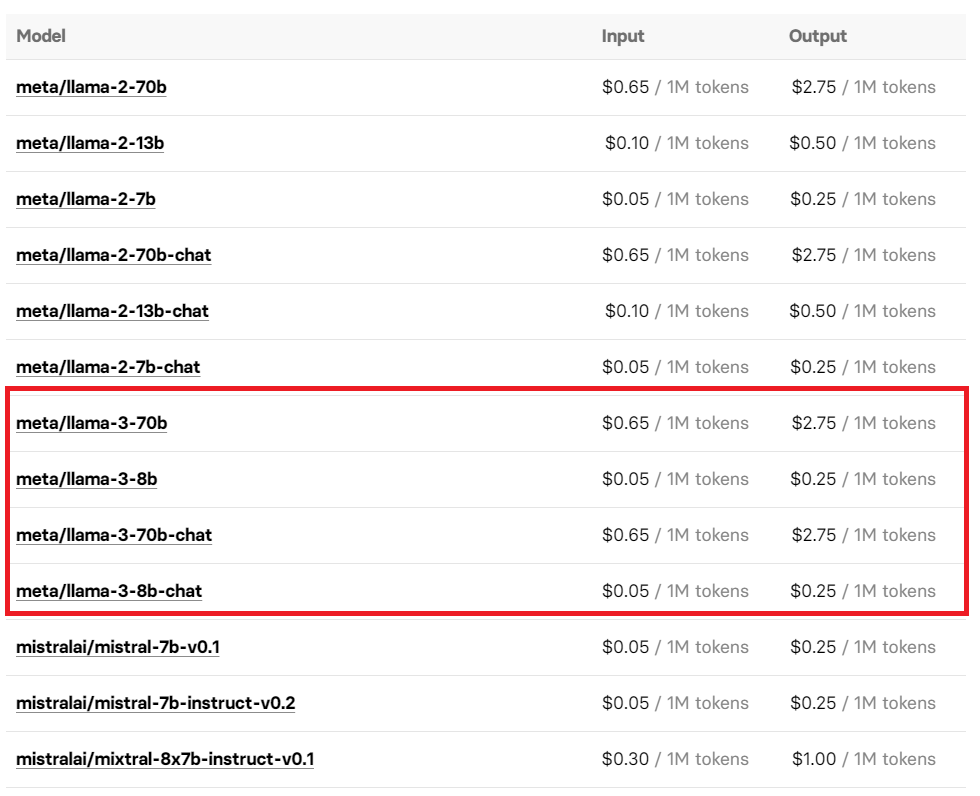
오픈소스 모델 플랫폼의 Replicate API 인터페이스를 호출하여 Llama 3를 체험해 볼 수도 있으니, 이용 가격도 공개되어 있으니 필요에 따라 이용하시면 좋을 것 같습니다.
흥미롭게도 Meta가 Llama 3를 공식적으로 발표하기 전에 예민한 네티즌들은 Microsoft의 Azure 시장이 Llama 3 8B Instruct 버전을 훔쳤다는 사실을 발견했습니다. "404" 페이지.
현재 복원됨: https://azuremarketplace.microsoft.com/en-us/marketplace/apps/metagenai.meta-llama-3-8b-chat-offer?tab=overview
Llama 3의 등장으로 소셜 플랫폼 X에 대한 새로운 논의의 폭풍이 시작되고 있습니다.
Meta AI 수석 과학자이자 Turing Award 수상자 Yann LeCun은 Llama 3의 출시를 응원했을 뿐만 아니라 향후 몇 달 내에 더 많은 버전이 출시될 것이라고 다시 한 번 예측했습니다. 심지어 머스크도 댓글란에 등장해 '나쁘지 않다'는 간결하고 함축적인 말로 라마 3에 대한 인식과 기대를 표현했다.
NVIDIA의 수석 과학자인 JIm Fan은 곧 출시될 Llama 3 400B+에 관심을 집중했습니다. 그의 관점에서 Llama 3의 출시는 기술적 진보에서 벗어나 오픈 소스 모델이자 최고의 폐쇄 소스 모델의 상징입니다. .
공유한 벤치마크 테스트에서 Llama 3 400B+의 강도는 Claude Extra Large Cup 및 GPT-4 Turbo의 새 버전과 거의 비슷하다는 것을 알 수 있지만 여전히 어느 정도 격차가 있음을 입증하기에는 충분합니다. 최고의 대형 모델 중 하나입니다.

오늘은 스탠포드 대학교 교수이자 AI 분야의 최고 전문가인 Andrew Ng의 생일과 일치합니다. Llama 3의 등장은 의심할 여지없이 그의 생일을 축하하는 가장 특별한 방법입니다.
오늘날의 오픈 소스 모델은 실제로 백 송이의 꽃을 피우고 백 가지 학파가 경쟁하도록 하고 있다고 말해야 합니다.
올해 초 350,000개의 GPU를 보유하고 있는 Zuckerberg는 The Verge와의 인터뷰에서 AGI(Artificial General Intelligence) 구축에 전념하는 Meta의 비전을 확고한 어조로 설명했습니다.
공개되지 않은 OpenAI와는 대조적으로 Meta는 오픈소스 경로를 따라 AGI의 성배를 향한 돌진을 시작했습니다.
Zuckerberg가 말했듯이 확고한 오픈 소스인 Meta는 이 어려운 여정에서 아무것도 얻지 못했습니다.
저는 일반적으로 오픈 소스가 커뮤니티에 좋고 우리가 혁신의 혜택을 받기 때문에 우리에게 좋다고 생각하는 경향이 있습니다.
지난 한 해 동안 AI계 전체는 오픈소스냐, 클로즈드소스냐를 중심으로 끝없이 논쟁을 벌여왔습니다. 이 논쟁은 기술적인 차원의 장단점 비교를 넘어, 향후 AI 발전의 핵심 방향을 다뤘습니다. 직접 나간 머스크도 오픈소스 그록 1.0으로 세상에 변화를 가져왔다.
얼마 전까지만 해도 오픈 소스 모델이 점점 낙후될 것이라는 의견도 있었습니다. 이제 Llama 3의 등장으로 이러한 비관적인 견해도 큰 충격을 받았습니다.
그러나 Llama 3가 오픈 소스 모델에 어느 정도 안도감을 주긴 했지만 오픈 소스와 폐쇄 소스에 대한 논쟁은 아직 끝나지 않았습니다.
결국, 비밀리에 출시를 준비하고 있는 GPT-4.5/5는 올 여름 타의 추종을 불허하는 성능으로 이 오랜 논쟁을 종식시킬 수도 있습니다.
# Aifaner: Aifaner(WeChat ID: ifanr)의 공식 WeChat 공개 계정을 팔로우하신 것을 환영합니다. 더 흥미로운 콘텐츠가 최대한 빨리 제공될 예정입니다.
Ai Faner | 원본 링크 · 댓글 보기 · Sina Weibo