
최근 블룸버그 보도에 따르면 소프트뱅크그룹 비전펀드 2호가 미국 인공지능 스타트업 퍼플렉시티 AI(Perplexity AI)에 투자를 앞두고 있다.
소식통에 따르면 소프트뱅크의 투자금액은 1000만~2000만달러이며, 이번 라운드에서 퍼플렉시티가 조달한 총액은 2억5000만달러를 넘었다.
이번 자금 조달 라운드는 Perplexity의 가치를 잠재적으로 25억~30억 달러로 3배 높여 업계에서 가장 가치가 높은 회사 중 하나로 만들 것으로 예상됩니다.
퍼플렉시티(Perplexity)는 인공지능을 이용해 구글 검색과 경쟁하는 것을 목표로 한다.
스타트업 유니콘 회사로서 핵심 서비스는 기존 검색 엔진과 근본적으로 다른 '답변 엔진'을 제공하는 것입니다.
질문의 기본 소스를 찾기 위해 여러 결과를 검색하는 대신 사용자는 Perplexity가 찾은 답변을 직접 얻을 수 있습니다.
Aravind Srinivas는 OpenAI의 연구 과학자였습니다. 그는 OpenAI를 떠난 후 2022년 8월 Perplexity를 설립했습니다.
Perplexity는 사용자에게 수많은 정보를 샅샅이 조사할 필요 없이 빠르고 정확한 답변을 제공하고자 합니다.
Aravind Srinivas는 The Verge와의 인터뷰에서 다음과 같이 말했습니다.
우리는 진정성과 정확성을 중시합니다.
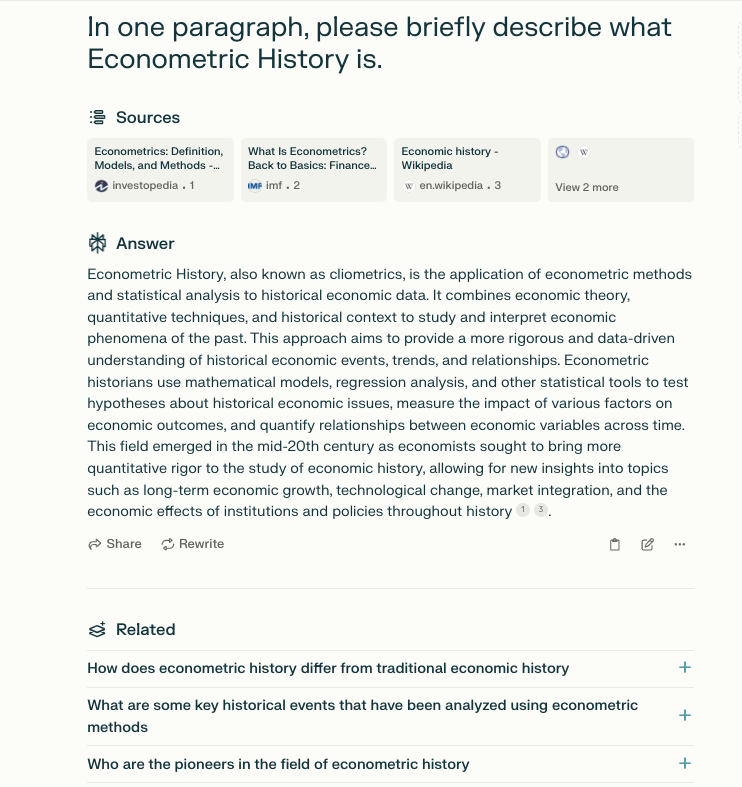
"세계 최초의 대화형 답변 엔진"인 Perplexity의 답변 인터페이스는 매우 깨끗합니다. 결과 페이지 상단에는 정보의 출처, 중앙에는 답변, 하단에는 확장 질문이 있습니다.
독특한 특징은 ChatGPT 스타일의 질문과 답변을 기존 검색 엔진의 링크 목록과 결합하여 새로운 검색 경험을 만든다는 것입니다.
Wired와의 이전 인터뷰에서 Huang은 "Perplexity를 사용해 왔다"고 말했습니다.
물론 그는 ChatGPT도 매우 좋다고 생각합니다. 인터뷰 동안 Huang Renxun은 컴퓨터 기반 약물 발견 분야에 특히 관심이 있었고 연구를 위해 "거의 매일 이 두 가지를 사용했습니다."
아마도 당신은 컴퓨터를 이용한 약물 발견 분야의 발전에 대해 배우고 싶을 것입니다.
그런 다음 먼저 주제를 중심으로 프레임워크를 구축한 다음 해당 프레임워크에서 보다 구체적인 질문을 해야 합니다.

Perplexity의 비즈니스 모델은 이론적으로 매력적이지만 중개자로서의 역할로 인해 일부 콘텐츠 제작자가 걱정할 수도 있습니다.
Arc Search 및 Google Gemini와 마찬가지로 Perplexity는 질문을 검색한 후 바로 답변 결과를 제공합니다.
이렇게 하면 원본 콘텐츠 웹사이트의 트래픽과 광고 수익에 확실히 영향을 미치게 됩니다.

Google 및 Baidu와 같은 기존 검색 엔진의 경우 대부분의 정보는 사용자가 키워드를 통해 검색할 수 있도록 크롤러에 의해 자동으로 크롤링됩니다.
크롤러는 웹사이트 정보를 신속하게 검색하고 구성할 수 있지만 모든 콘텐츠를 아무 생각 없이 크롤링하지는 않습니다. 일반적으로 웹사이트가 생성되면 Robots 프로토콜 파일(예: robots.txt)이 설정됩니다.
이 파일을 통해 웹사이트는 검색 엔진 크롤러에게 크롤링할 수 있는 웹페이지와 크롤링할 수 없는 웹페이지를 알려줄 수 있습니다. 이는 주로 크롤러 개발자의 규정 준수에 의존하는 비필수 계약입니다.
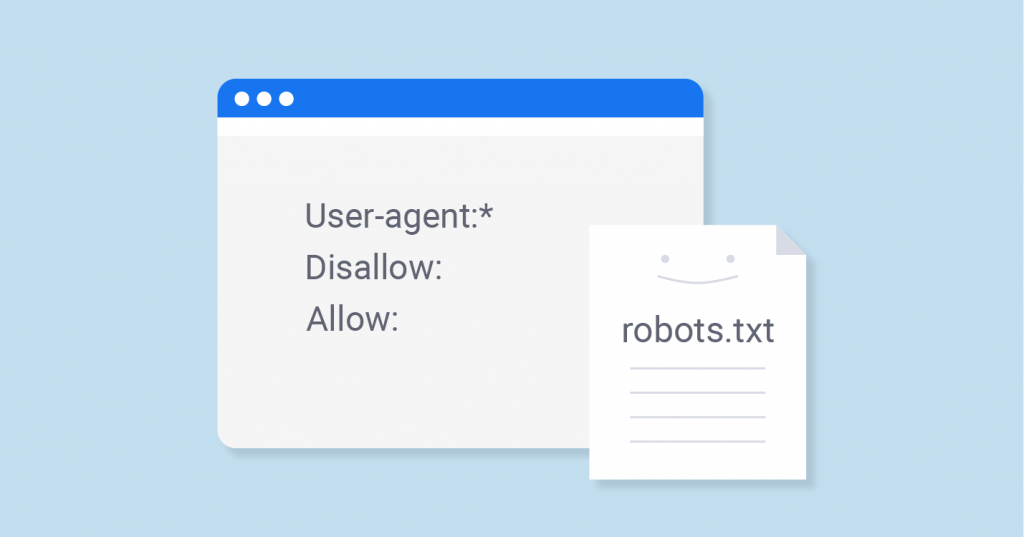
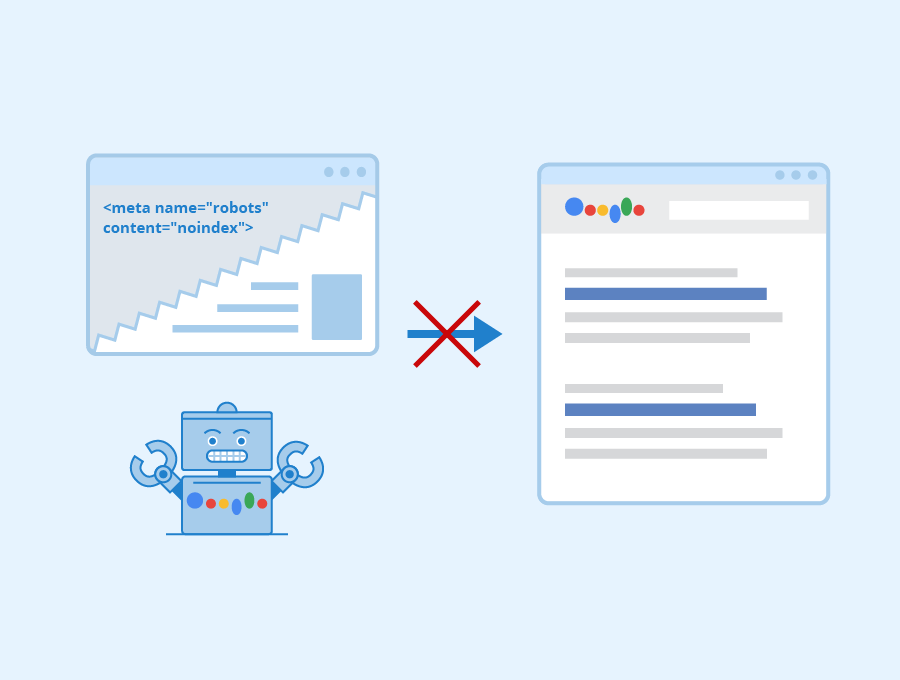
대부분의 검색 엔진과 크롤러 개발자는 로봇 계약을 존중하며 웹사이트에서 크롤링을 명시적으로 금지하는 콘텐츠를 크롤링하지 않습니다. 이는 웹사이트의 개인 정보 보호와 저작권을 존중하고 법적 문제를 피하기 위해 수행됩니다.
이 프로토콜을 따르지 않으면 크롤러는 웹사이트 콘텐츠에 강제로 액세스하게 됩니다. 이로 인해 발생하는 또 다른 결과는 일부 웹사이트 페이월이 효과가 없게 될 수 있다는 것입니다.
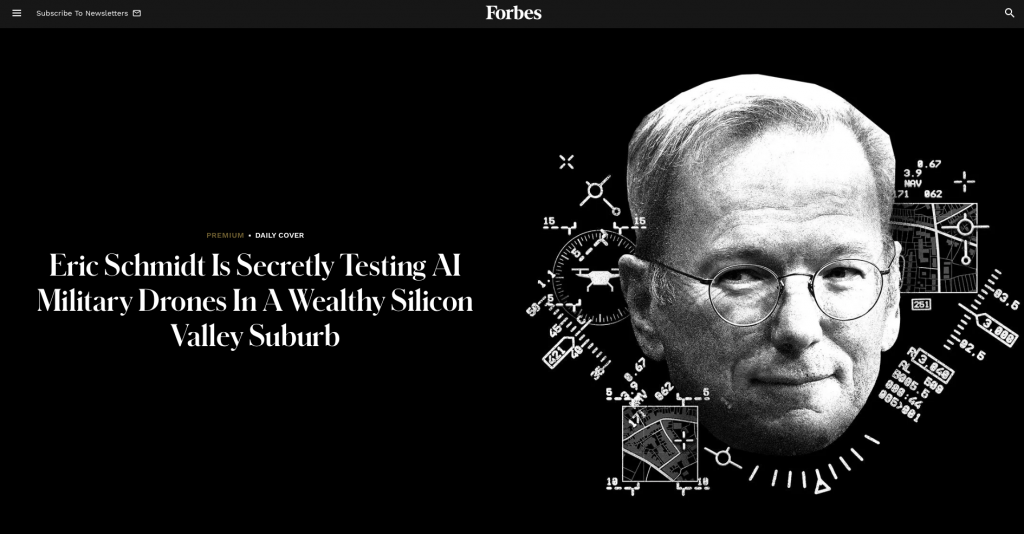
얼마 전 누군가 Perplexity를 사용하여 Eric Schmidt의 비밀 드론 프로젝트를 요약하려고 했습니다.
그러나 Perplexity가 제공한 결과를 보면 여러 클립이 Forbes의 독점 보고서에서 가져온 것을 알 수 있으며 Forbes가 만든 원본 일러스트레이션도 제공됩니다.
나중에 Forbes는 Perplexity를 사용하여 콘텐츠를 생성하려고 적극적으로 시도한 후 여러 기사의 주제를 검색한 후 Perplexity가 제공한 답변에 자체 텍스트 콘텐츠가 자주 나타나는 것을 발견했습니다.
그 중 페이월을 적용한 독점 보도 기사도 많다. Perplexity는 Forbes의 페이월을 우회하고 허가 없이 많은 원본 이미지와 텍스트를 사용합니다.
그뿐만 아니라, Perplexity가 제공한 답변 텍스트에는 정보의 출처가 표시되지 않습니다. 유일한 속성은 이러한 미디어에 연결되는 몇 가지 아이콘이지만 크기가 매우 작아 놓치기 쉽습니다.

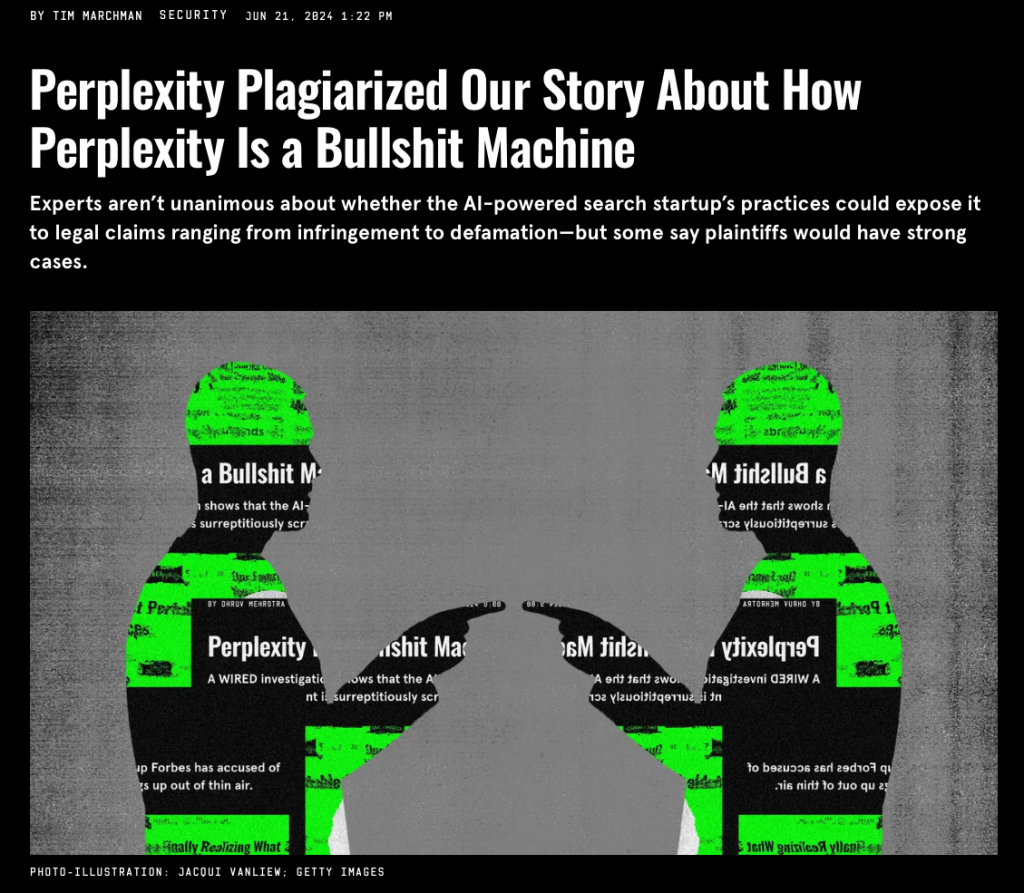
Forbes 외에도 또 다른 유명 언론 매체 Wired도 Perplexity를 고소하고 있습니다.
Wired는 Perplexity에 대한 이전 기사를 작성했는데, 이 기사에서는 Perplexity가 크롤러를 사용하여 차단된 웹 사이트 콘텐츠를 크롤링하려고 한다고 보고했습니다.
그러나 이상한 일이 일어났습니다. Perplexity는 Wired에서 이 기사를 "훔쳤습니다". 비록 기사가 그 자체에 관한 것이었지만 Wired는 웹 사이트의 관련 문서에서 Perplexity의 액세스를 명시적으로 차단했습니다.
Wired 개발자 Robb Knight가 이면의 데이터를 살펴보았습니다.
Wired는 광범위한 분석을 통해 Perplexity와 연관될 가능성이 높고 Perplexity의 공용 IP 범위 내에 있지 않은 특정 IP 주소를 식별했습니다.
콘텐츠 제작 사이트의 분위기를 진정시키기 위한 노력의 일환으로 Perplexity의 최고 상업 책임자인 Dmitry Shevelenko는 Semafor와의 인터뷰에서 Perplexity가 게시자와 수익 공유 계획을 개발하고 있다고 말했습니다.
Perplexity는 아직 이들 파트너에 대한 세부 정보를 발표하지 않았지만 Dmitry Shevelenko는 가능한 한 빨리 계획을 발표할 것이라고 말했습니다.
Aravind Srinivas도 Fast Company와의 인터뷰에서 이 문제에 대해 다음과 같이 응답했습니다.
실제로 Perplexity는 robots.txt를 무시하지 않고 이를 무시하는 타사 크롤러를 사용합니다.
그러나 Aravind Srinivas는 제3자 스크레이퍼의 이름을 밝히기를 거부했으며 스크레이퍼에게 robots.txt 위반을 중단하라고 요청하지도 않았습니다.
Perplexity에게 물어보면 "AI 검색엔진으로서 남의 글을 무단으로 인용하는 것에 대해 어떻게 생각하시나요?"
다음과 같은 답변을 제공합니다.

Perplexity 자체도 그렇게 하는 것이 어느 정도 위험하고 불법이라는 것을 알고 있는 것 같습니다.
저널리즘을 예로 들어보겠습니다. 새로운 기사를 써야 한다면 어떻게 하시겠습니까?
다른 사람의 말을 인용하여 "New York Times에 따르면"이라고 말할 수 있습니다. 이것이 바로 우리가 하고 있는 일입니다.
Perplexity의 CEO인 Dmitry Shevelenko는 이렇게 말했습니다.
어쨌든 Perplexity가 규정을 준수하면서 더욱 혁신적인 AI 도구를 계속해서 만들 수 있기를 바랍니다.
# aifaner 공식 WeChat 공개 계정: aifaner(WeChat ID: ifanr) 팔로우를 환영합니다. 더 흥미로운 콘텐츠가 최대한 빨리 제공될 예정입니다.
Ai Faner | 원본 링크 · 댓글 보기 · Sina Weibo