
방금 Meta는 예정대로 Llama 3.1 모델을 출시했습니다.
간단히 말해서, 새로 출시된 Llama 3.1 405B는 현재까지 Meta의 가장 강력한 모델이자, 세계에서 가장 강력한 오픈소스 대형 모델이기도 합니다.
이제부터는 오픈 소스 대형 모델과 폐쇄 소스 대형 모델의 장점에 대해 논쟁할 필요가 없습니다. Llama 3.1 405B는 경로를 둘러싼 싸움이 최종 기술 강도에 영향을 미치지 않는다는 것을 반박할 수 없는 힘으로 입증했기 때문입니다.
먼저 Llama 3.1 모델의 특징을 요약해 보겠습니다.
- 8B, 70B, 405B 세 가지 크기가 포함되어 있으며 최대 컨텍스트가 128K로 증가했으며 다국어를 지원하고 뛰어난 코드 생성 성능을 가지며 복잡한 추론 능력과 도구 사용 기술을 갖추고 있습니다.
- 벤치마크 테스트 결과에 따르면 Llama 3.1은 GPT-4o 및 Claude 3.5와 경쟁하여 GPT-4 0125를 능가했습니다.
- 개방형/무료 모델 가중치 및 코드를 제공하는 라이선스를 통해 사용자는 모델을 미세 조정하고 다른 형식으로 추출하며 어디에서나 배포를 지원할 수 있습니다.
- 통합 사용을 용이하게 하는 Llama Stack API를 제공하고 외부 도구 호출을 포함한 여러 구성 요소의 조정을 지원합니다.
첨부된 모델 다운로드 주소는 다음과 같습니다.
https://huggingface.co/meta-llama
https://llama.meta.com/
초대형 컵은 세계에서 가장 강력한 모델의 정점에 도달하고, 중형 및 대형 컵에는 놀라움이 숨겨져 있습니다.
이번에 출시된 라마 3.1은 8B, 70B, 405B 세 가지 사이즈 버전으로 출시된다.
벤치마크 테스트 결과에 따르면 초대형 Llama 3.1 405B는 GPT-3.5 Turbo의 모든 압력을 견딜 수 있으며 대부분의 벤치마크 테스트 점수는 GPT-4 0125를 초과합니다.
OpenAI가 이전에 출시한 가장 강력한 비공개 소스 대형 모델 GPT-4o와 1등급 Claude 3.5 Sonnet에 맞서 Super Cup은 여전히 라마 3.1이라는 논문 매개 변수만으로도 싸울 수 있는 힘을 가지고 있습니다. 405B는 오픈 소스를 나타냅니다. 처음으로 대형 모델이 폐쇄 소스 대형 모델을 따라잡았습니다.
벤치마크 결과를 구체적으로 분석하면, Llama 3.1 405B는 NIH/Multi-needle 벤치마크에서 98.1점을 기록했습니다. 비록 GPT-4o만큼 좋지는 않지만 복잡한 정보 처리 능력도 완벽하다는 것을 보여줍니다.
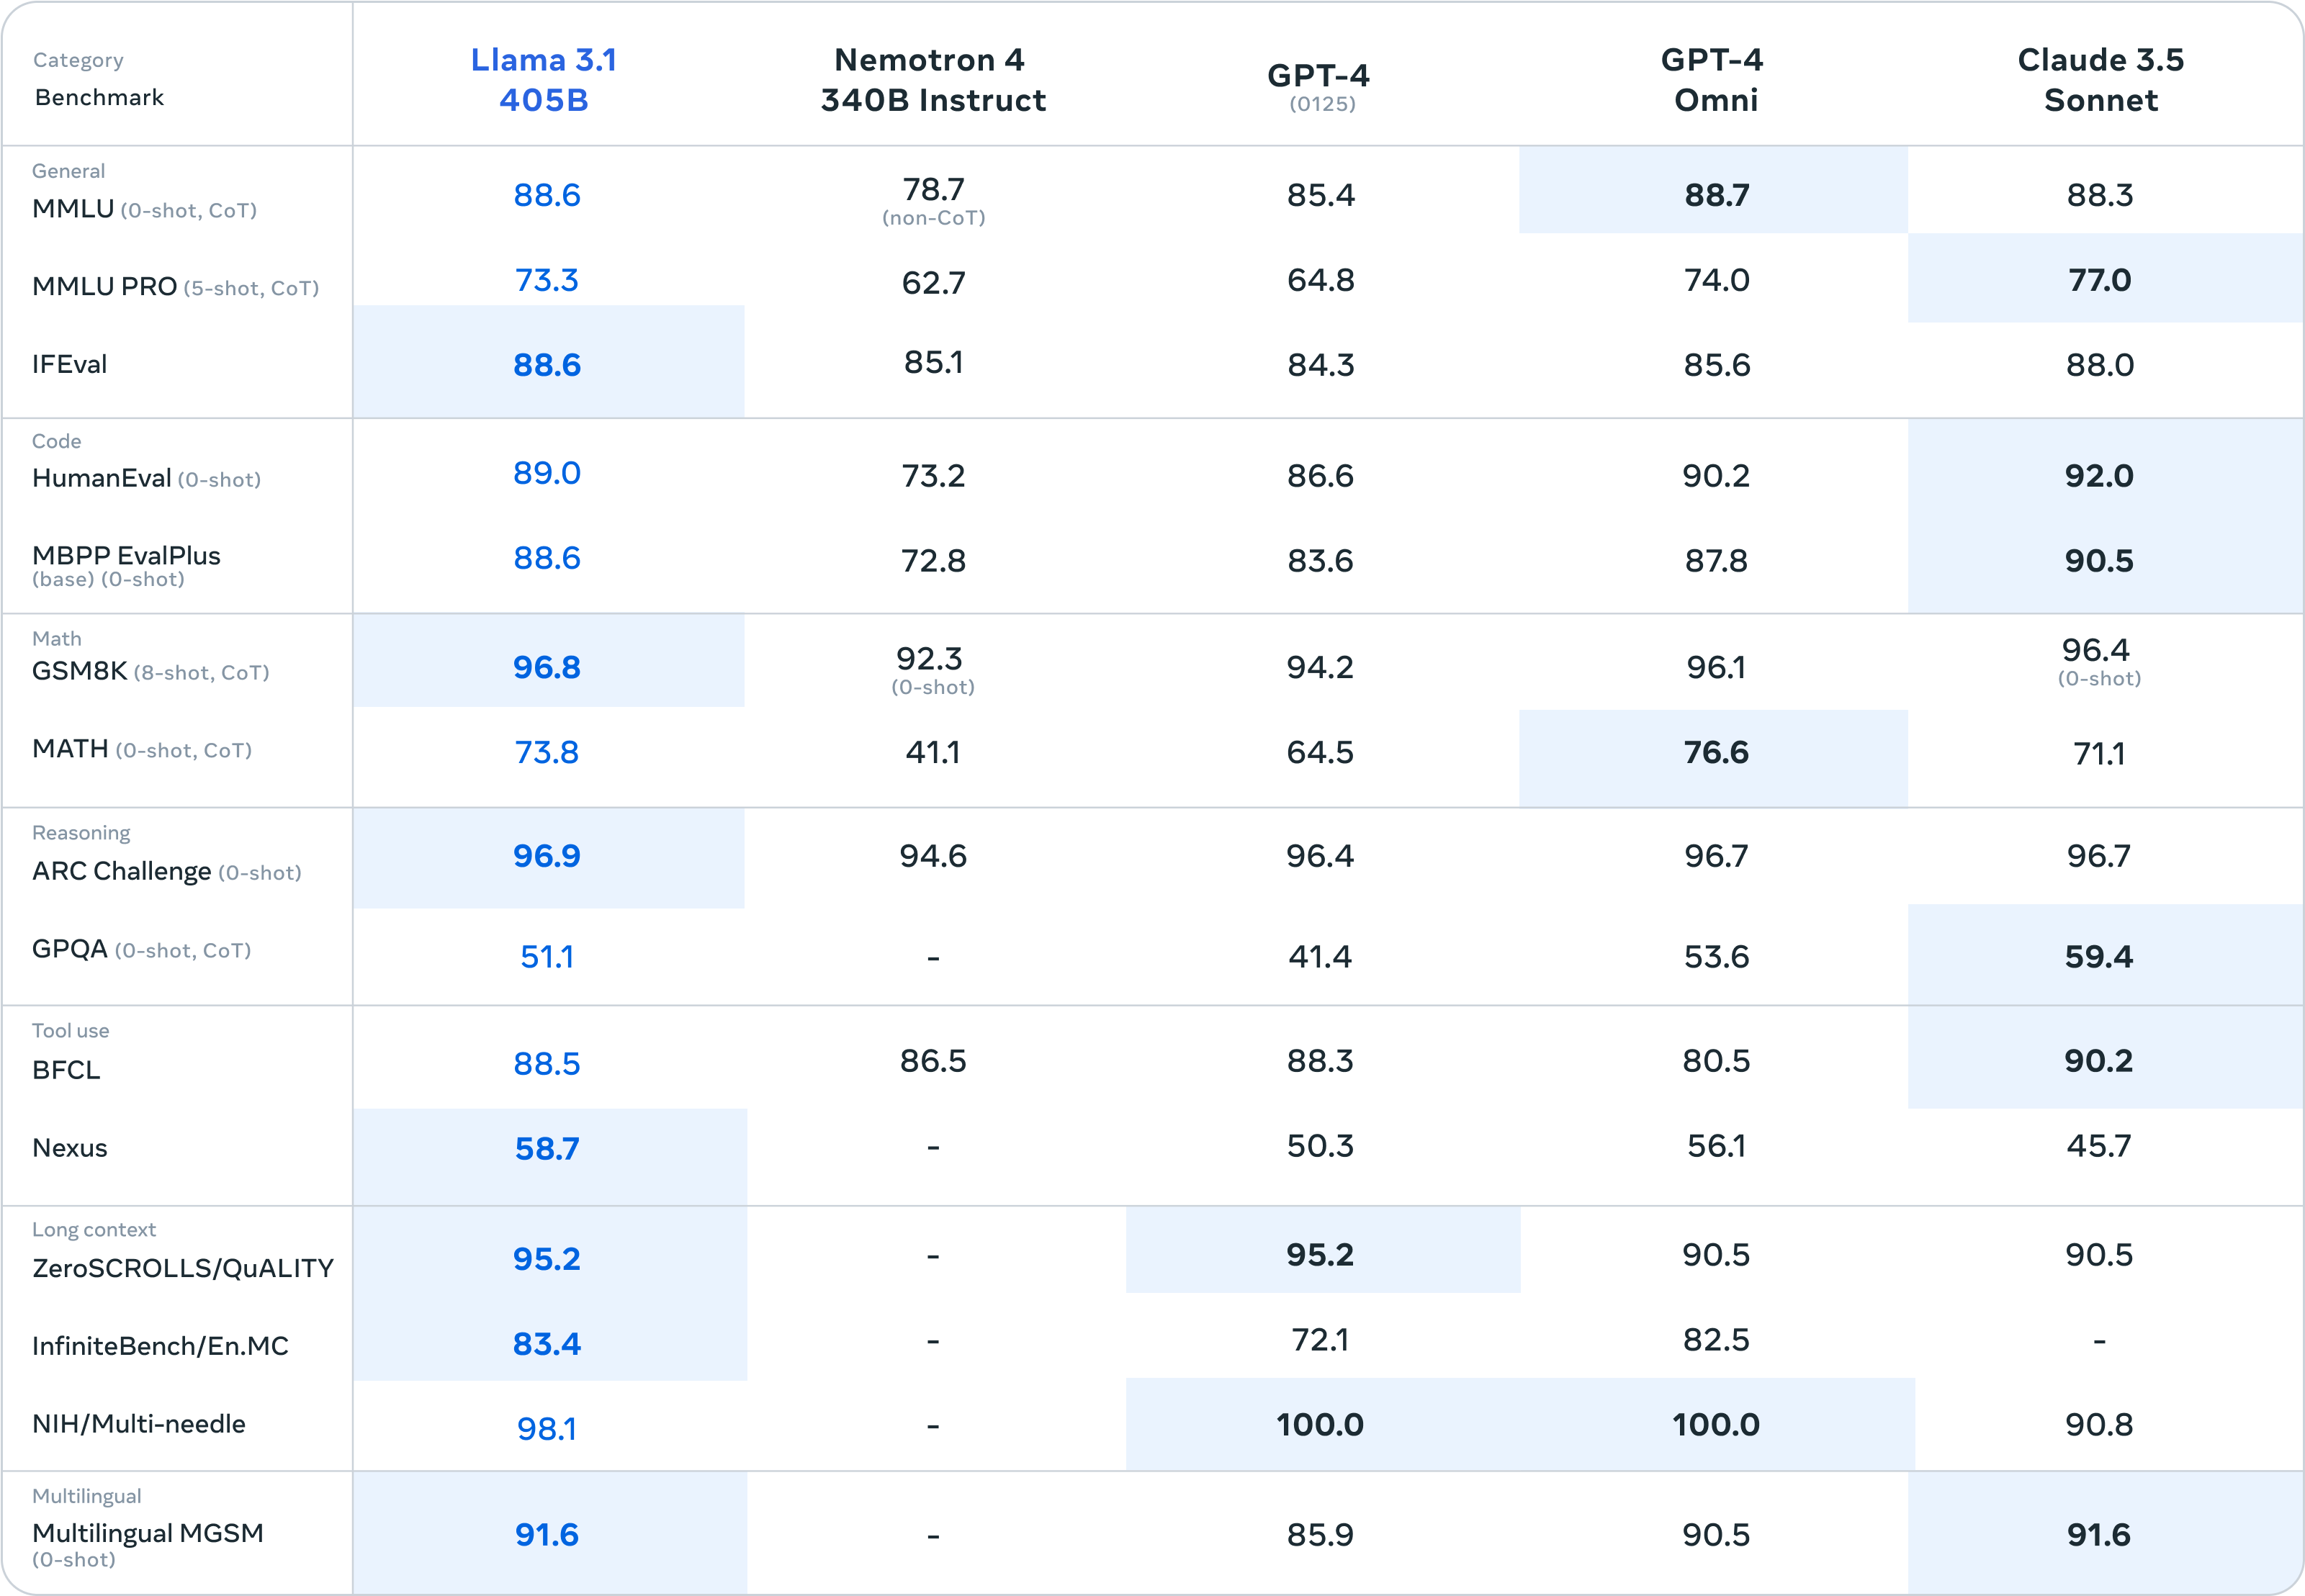
그리고 Llama 3.1 405B는 ZeroSCROLLS/QUALITY 벤치마크에서 95.2점을 얻었습니다. 이는 또한 대량의 텍스트 정보를 통합하는 강력한 능력을 가지고 있음을 의미합니다. 이러한 결과는 LLaMA3.1 405B 모델이 긴 텍스트 처리에 탁월하고 적합하다는 것을 보여줍니다. RAG의 LLM에 초점을 맞춘 AI 애플리케이션 개발자의 경우 성능이 매우 사용자 친화적입니다.
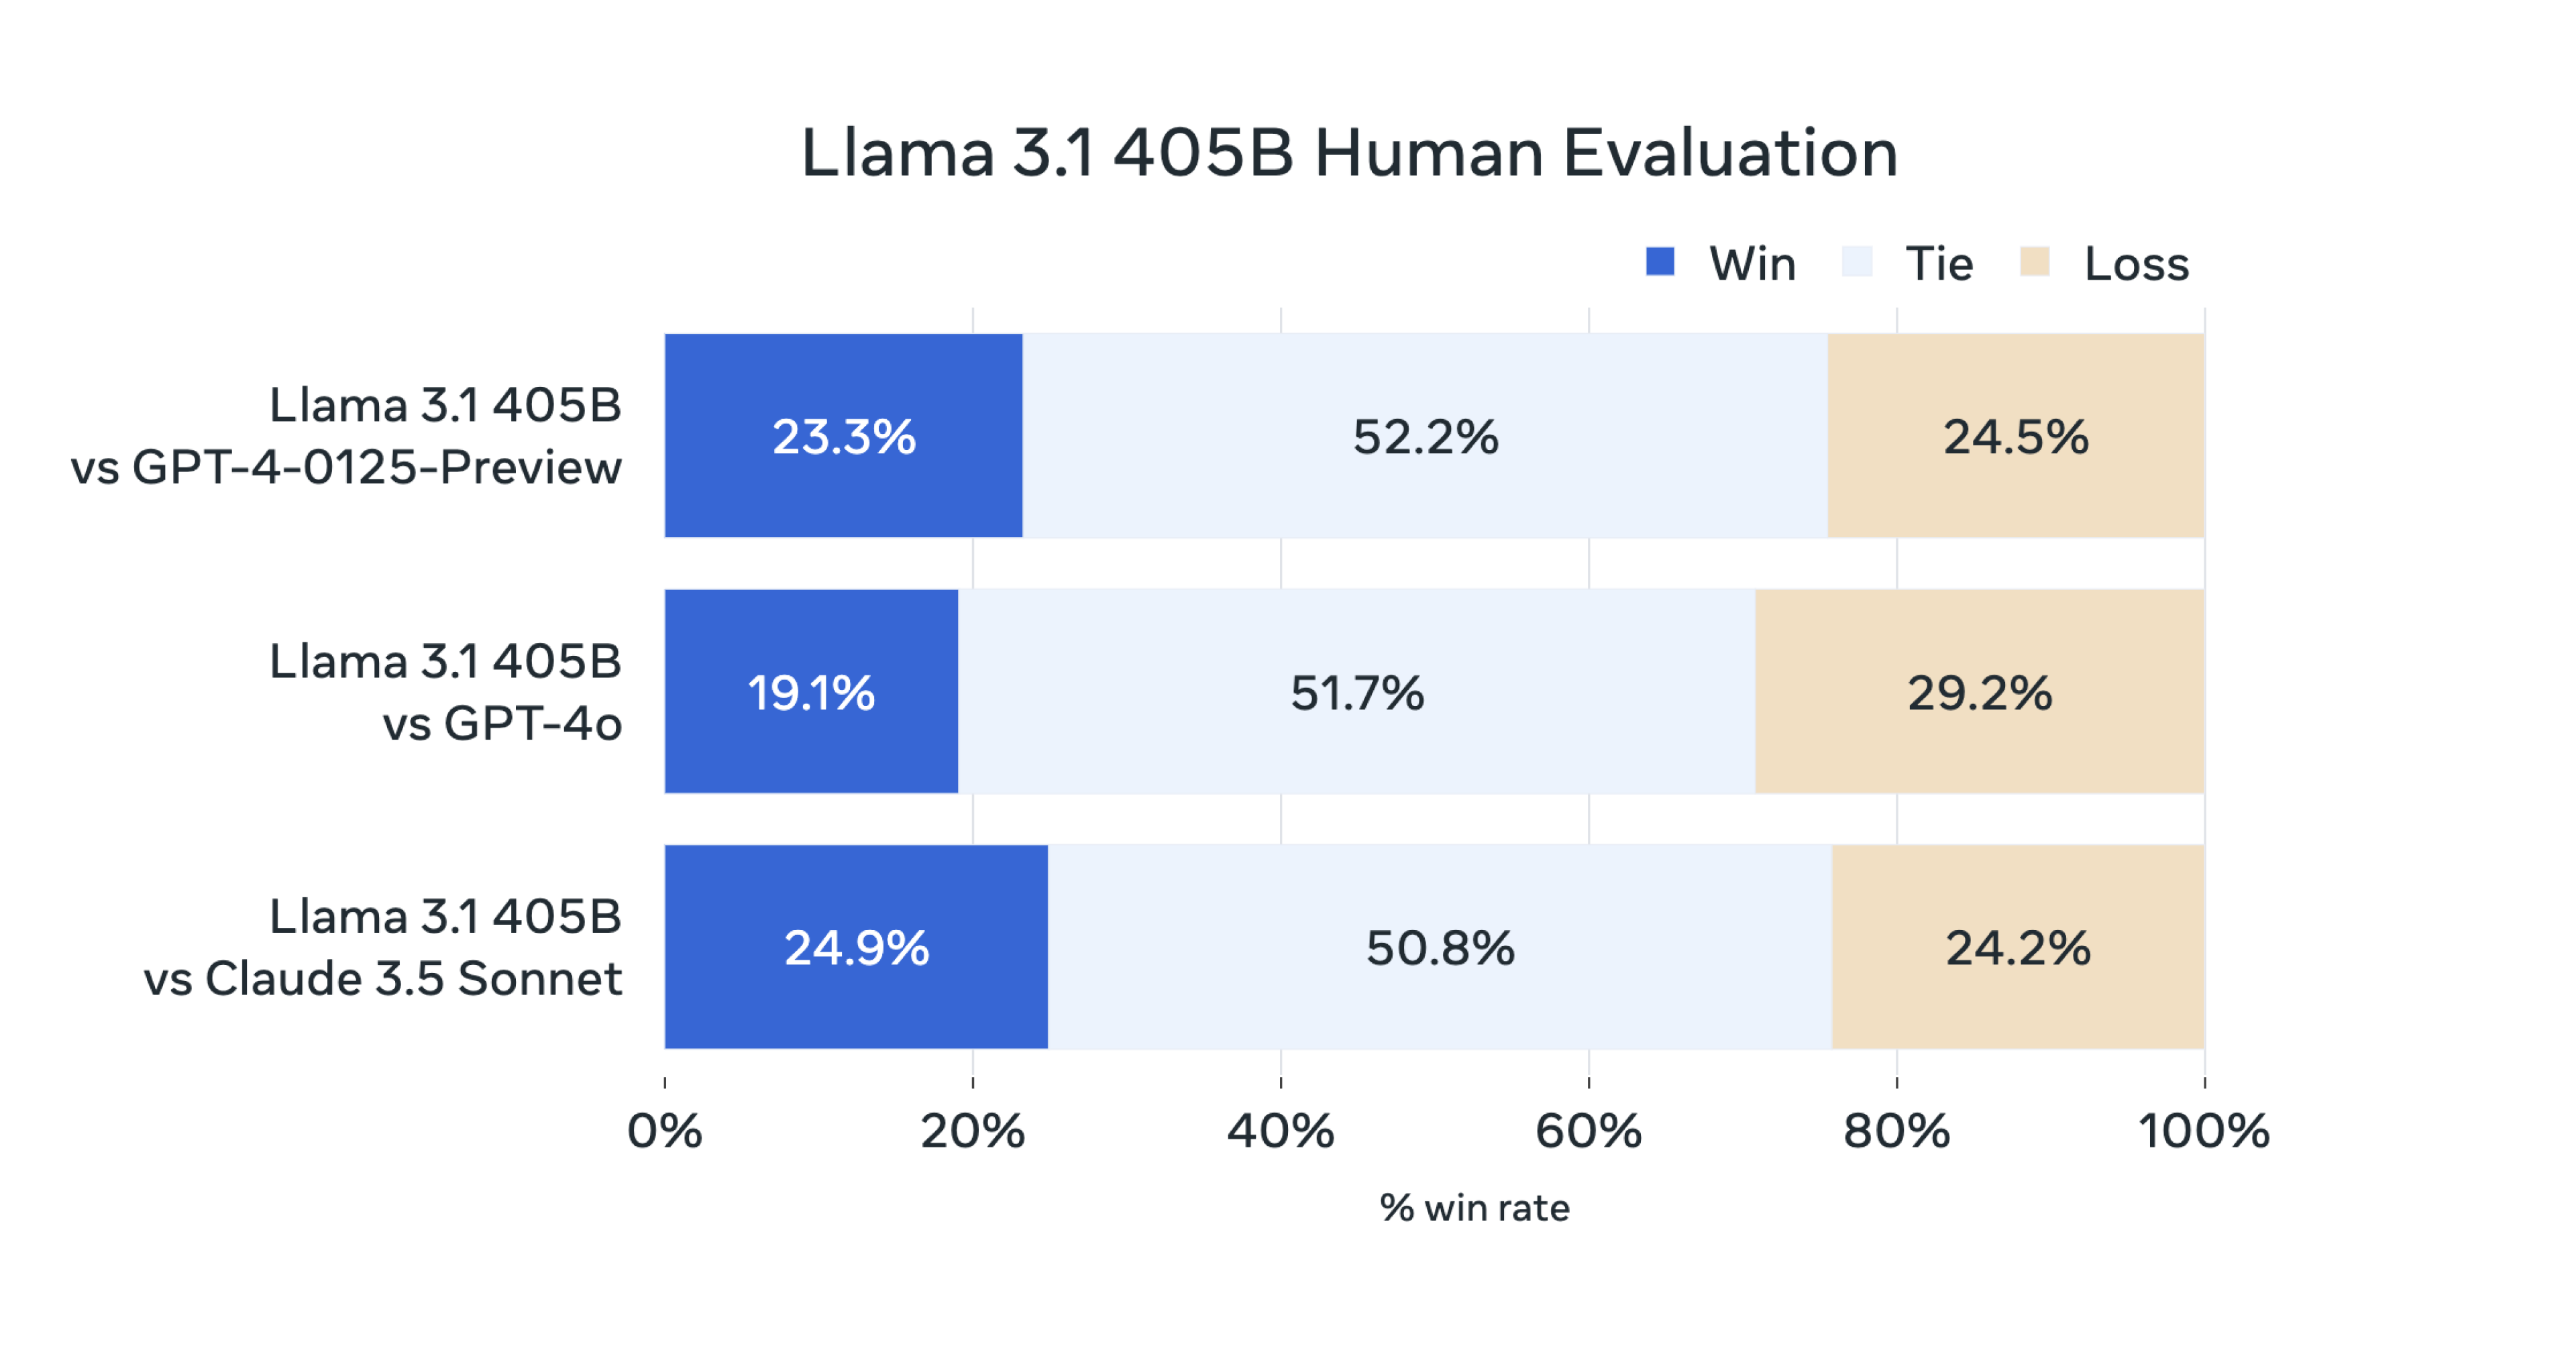
특히 우려되는 점은 Human-Eval이 모델의 코드 이해 및 생성 능력, 추상적인 논리 해결 능력을 벤치마킹하는 역할을 주로 담당하고 있으며, Llama 3.1 405B도 다른 대형 모델과의 경쟁에서 약간의 우위를 점하고 있다는 점입니다.
메인 코스인 라마 3.1 405B 외에도 사이드 메뉴인 라마 3.1 8B, 라마 3.1 70B도 '작은 승리'의 멋을 뽐냈다.
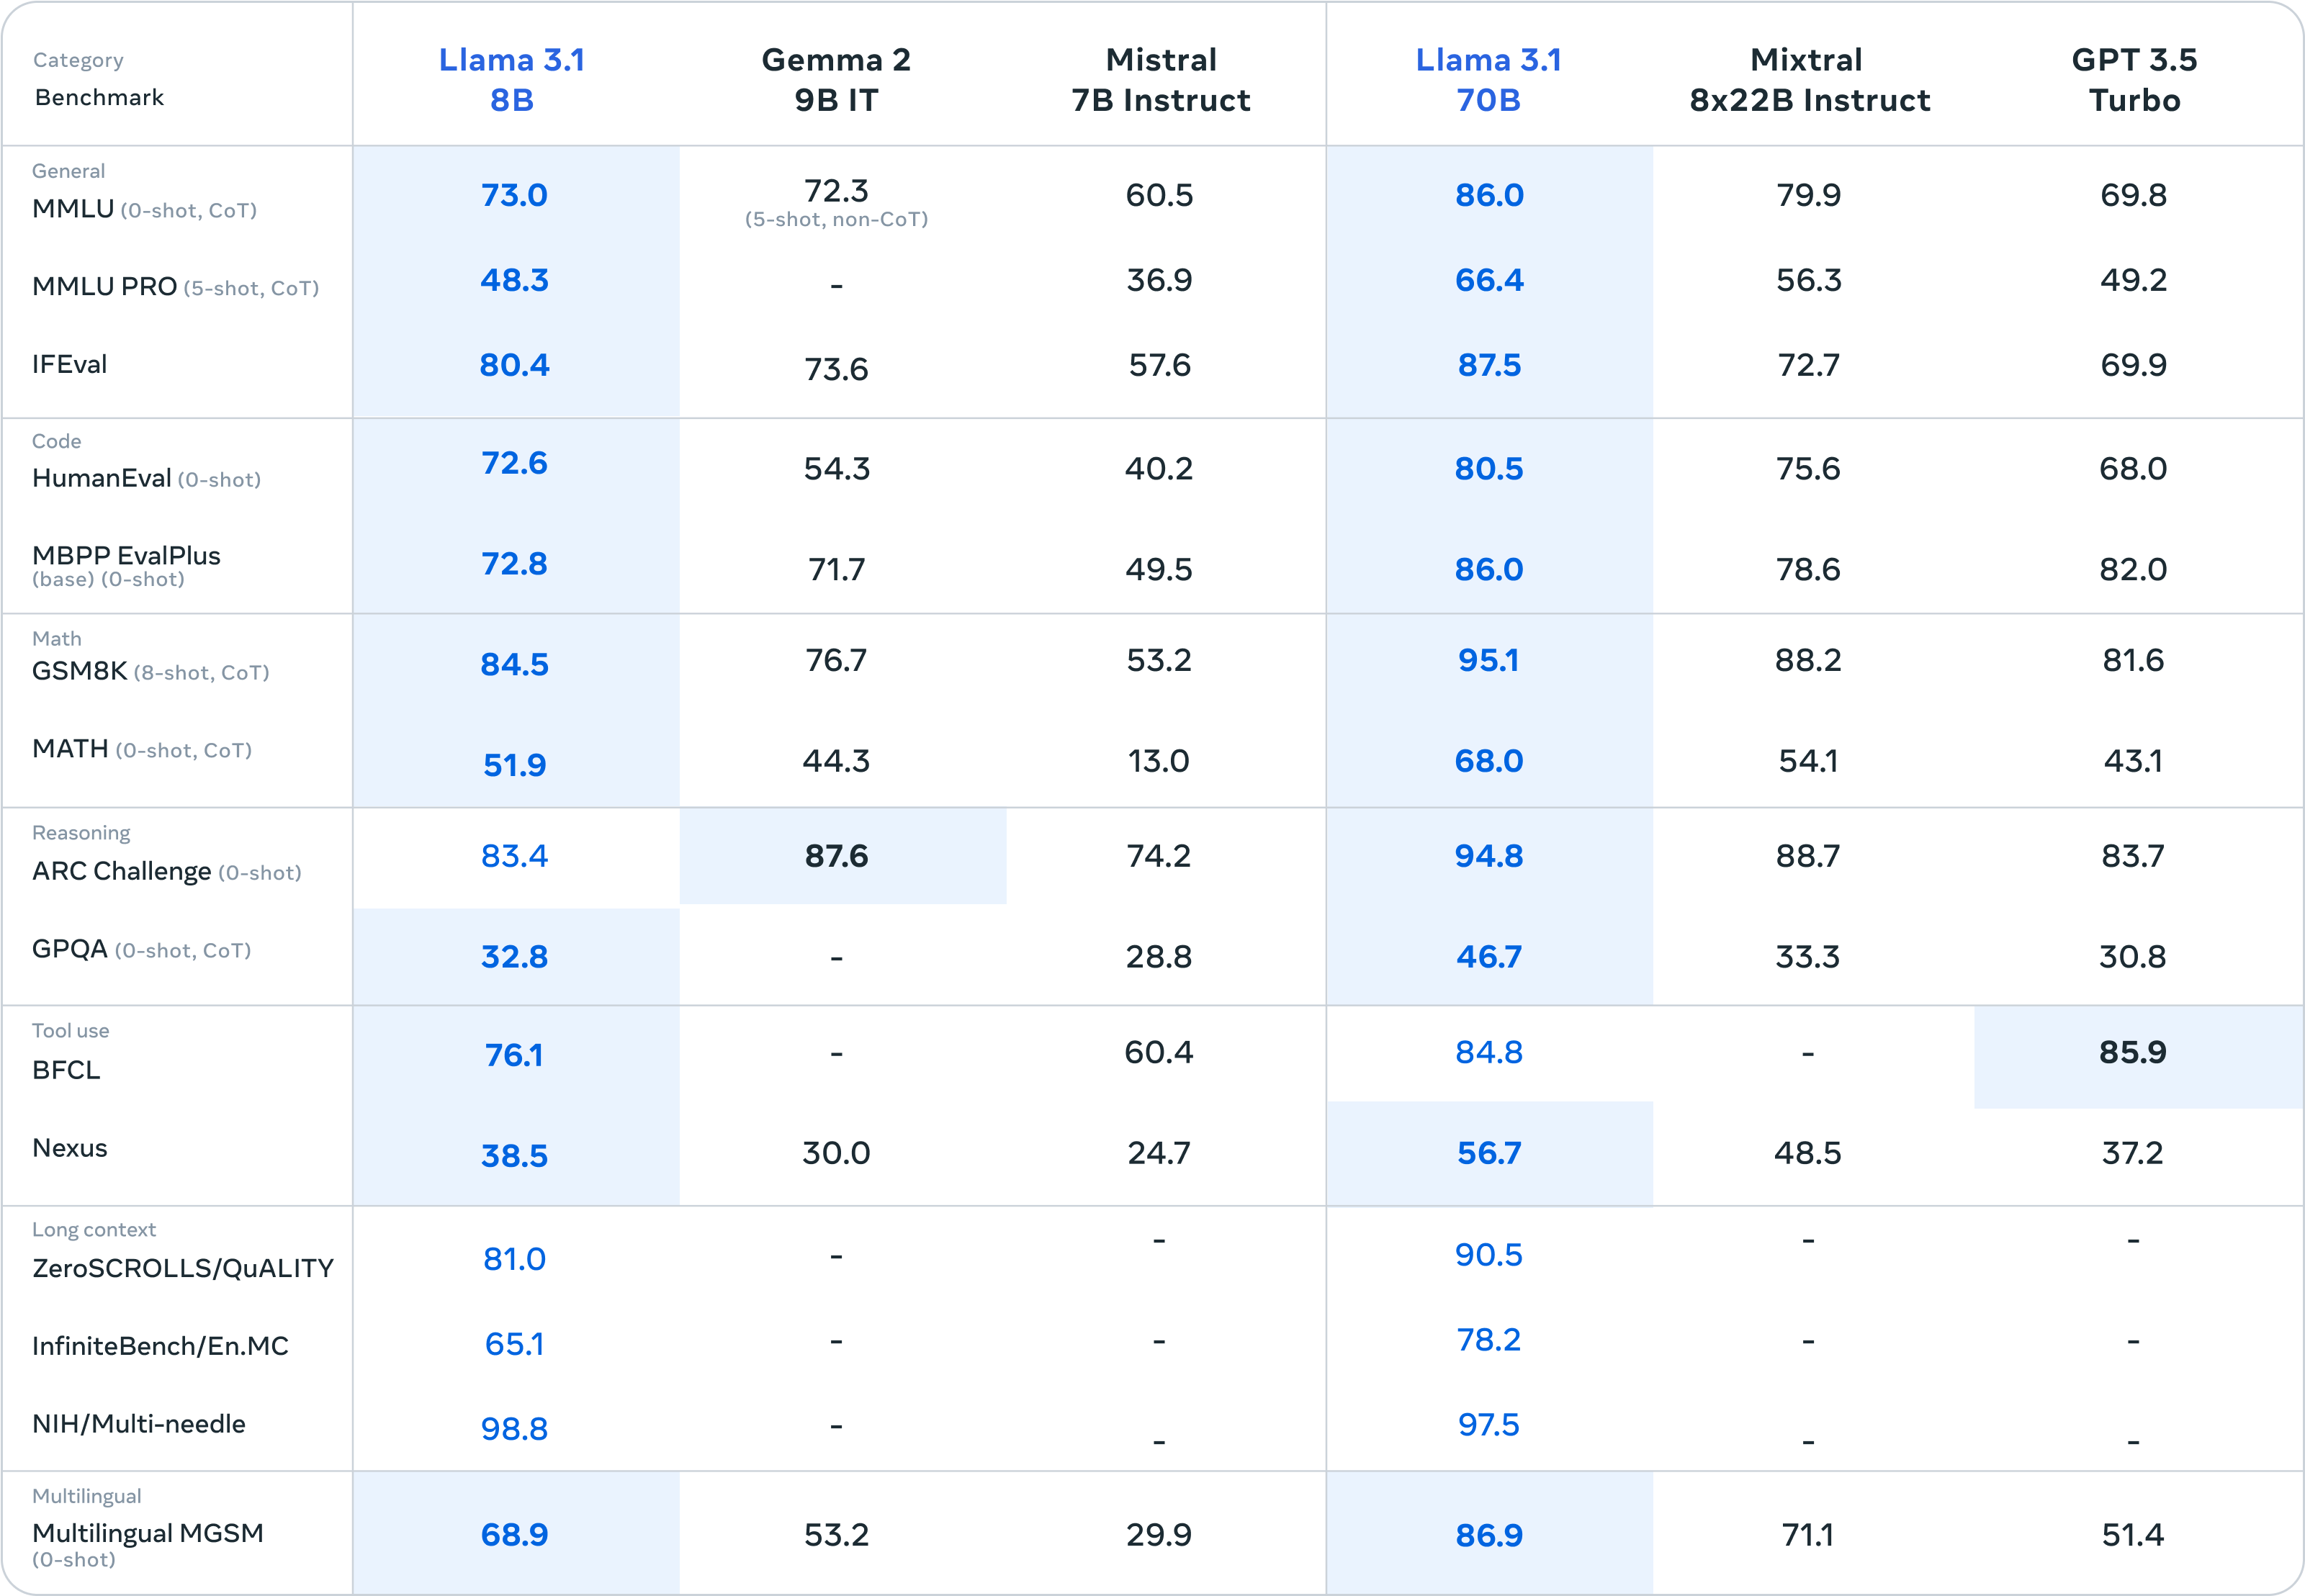
벤치마크 테스트 결과에 따르면 Llama 3.1 8B는 Gemma 2 9B 1T 및 Mistral 7B Instruct를 거의 압도했으며 전반적인 성능은 Llama 3 8B보다 훨씬 향상되었습니다. Llama 3.1 70B는 뛰어난 성능으로 GPT-3.5 Turbo 및 Mixtral 8×7B 모델보다 성능이 뛰어납니다.
공식 소개에 따르면, 이번 릴리스에서 Llama 연구팀은 여러 언어를 다루는 150개 이상의 벤치마크 데이터 세트에 대해 모델 성능을 평가했으며, 팀은 또한 다수의 수동 평가를 수행했습니다.
최종 결론은 다음과 같습니다.
당사의 플래그십 모델은 GPT-4, GPT-4o, Claude 3.5 Sonnet 등의 최상위 기본 모델과 다양한 작업에서 경쟁력을 갖추고 있습니다. 동시에, 우리의 소형 모델은 비슷한 수의 매개변수를 가진 폐쇄형 모델과 개방형 모델과 비교할 때 경쟁력도 보여줍니다.
라마 3.1 405B 제작 방법
그렇다면 Llama 3.1 405B는 어떻게 훈련되나요?
공식 블로그에 따르면 현재까지 Meta의 가장 큰 모델인 Llama 3.1 405B는 훈련에 15조 개 이상의 토큰을 사용합니다.
이 규모의 훈련을 달성하고 짧은 시간에 예상 결과를 달성하기 위해 연구팀은 전체 훈련 스택을 최적화하고 16,000개 이상의 H100 GPU에서 훈련했습니다. 이것은 또한 이러한 대규모로 훈련된 최초의 Llama 모델이기도 합니다. .
또한 팀은 모델 개발 프로세스를 확장 가능하고 단순하게 유지하는 데 중점을 두고 교육 프로세스 중에 몇 가지 최적화를 수행했습니다.
- 훈련 안정성을 극대화하기 위해 하이브리드 전문가 모델 대신 약간의 조정만 수행한 표준 디코더 Transformer 모델 아키텍처를 선택했습니다.
- 각 라운드에서 감독된 미세 조정 및 직접 선호도 최적화를 사용하여 반복적인 사후 훈련 절차가 사용됩니다. 이를 통해 연구팀은 모든 라운드에 대해 최고 품질의 합성 데이터를 생성하고 모든 기능의 성능을 향상시킬 수 있습니다.
- 이전 버전의 Llama 모델과 비교하여 연구팀은 사전 훈련 데이터에 대한 전처리 및 관리 파이프라인을 더 많이 개발하고 더 많은 개발을 포함하여 사전 훈련 및 사후 훈련에 사용되는 데이터의 양과 품질을 개선했습니다. 훈련 후 데이터에 대한 엄격한 품질 보증 및 필터링 방법.
Meta 관계자는 Scaling Law의 영향으로 새로운 플래그십 모델이 동일한 방법으로 훈련된 소형 모델보다 성능이 뛰어나다고 밝혔습니다.
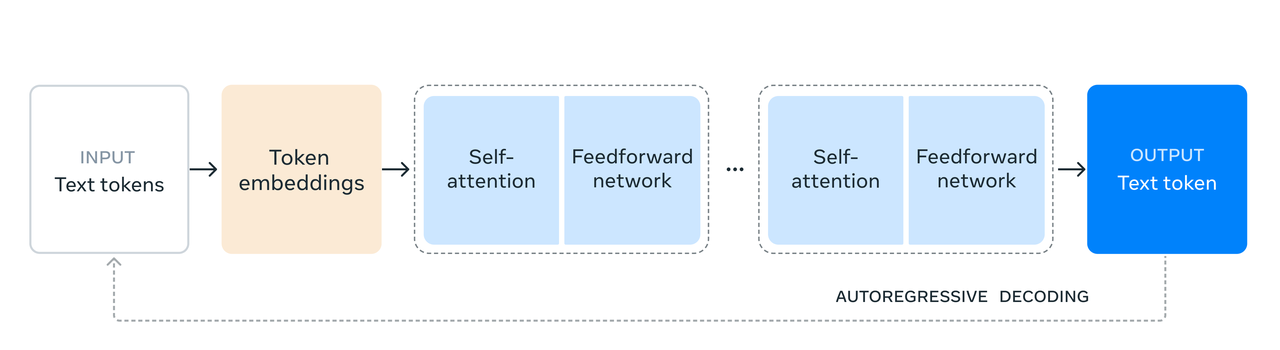
연구팀은 또한 405B 매개변수 모델을 사용하여 소형 모델의 학습 후 품질을 향상시켰습니다.
연구팀은 405B 규모 모델의 대량 생산 추론을 지원하기 위해 모델을 16비트(BF16) 정밀도에서 8비트(FP8) 정밀도로 양자화하여 필요한 컴퓨팅 리소스를 효과적으로 줄이고 모델을 실행할 수 있도록 했습니다. 단일 서버 노드에서 실행됩니다.
실용성과 안전성에 초점을 맞춘 디자인 등 Llama 3.1 405B에 대해 살펴볼 만한 몇 가지 세부 사항도 있어 사용자 지침을 더 잘 이해하고 실행할 수 있습니다.
감독된 미세 조정, 거부 샘플링 및 직접 선호도 최적화와 같은 방법을 통해 사전 훈련된 모델을 기반으로 여러 라운드의 정렬이 수행되어 Llama 3.1 405B는 특정 사용 시나리오에 보다 정확하게 적응할 수 있습니다. 사용자 요구 사항을 충족하여 실제 애플리케이션의 성능을 향상시킵니다.
Llama 연구팀은 합성 데이터 생성을 사용하여 대부분의 SFT 예제를 생성한다는 점을 언급할 가치가 있습니다. 즉, 실제 데이터에 의존하지 않고 알고리즘적으로 생성된 데이터를 사용하여 모델을 훈련한다는 의미입니다.
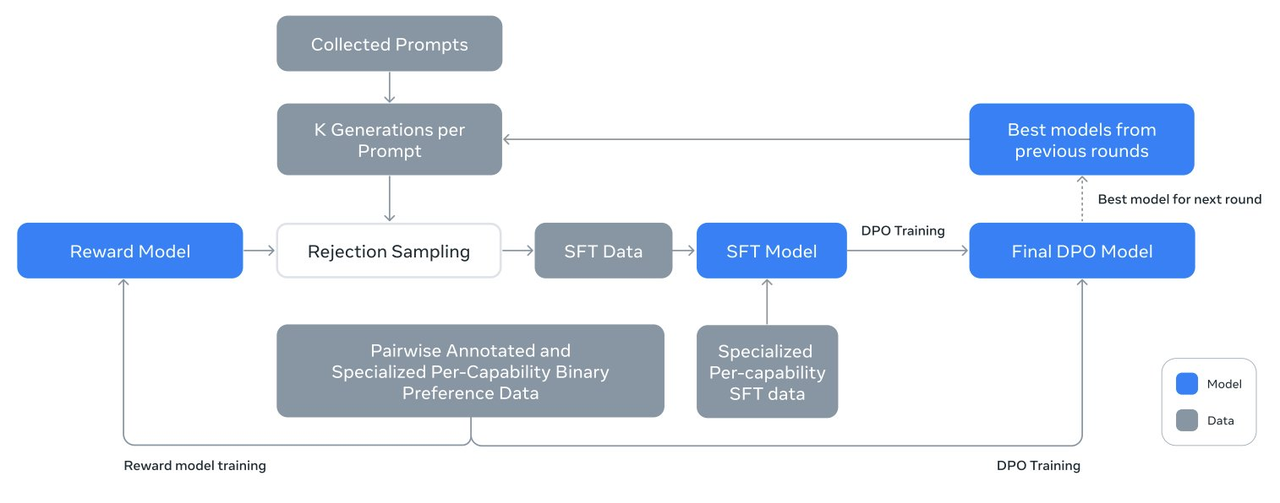
또한, 연구팀은 여러 반복 과정을 통해 합성 데이터의 품질을 지속적으로 향상시키고 있습니다. 연구팀은 합성 데이터의 높은 품질을 보장하기 위해 데이터 필터링 및 최적화를 위한 다양한 데이터 처리 기술을 사용했습니다.
이러한 기술을 통해 팀에서는 단일 기능에만 적용할 수 있는 것이 아니라 여러 기능에 걸쳐 사용할 수 있도록 미세 조정 데이터의 양을 확장하여 모델의 적용 가능성과 유연성을 높일 수 있습니다.
간단히 말해서, 이러한 합성 데이터 생성 및 처리 기술을 적용하면 고품질의 훈련 데이터를 대량으로 생성할 수 있어 모델의 일반화 능력과 정확성을 향상시키는 데 도움이 됩니다.
오픈 소스 모델 경로의 지지자로서 Meta는 Llama 모델의 "지원 시설"에도 성실함을 보여주었습니다.
- AI 시스템의 일부인 Llama 모델은 외부 도구 호출을 포함하여 여러 구성 요소의 조정을 지원합니다.
- 참조 시스템과 오픈 소스 샘플 애플리케이션을 게시하고 커뮤니티 참여와 협업을 장려하며 구성 요소 인터페이스를 정의합니다.
- "Llama Stack" 표준화된 인터페이스를 통해 도구 체인 구성요소와 에이전트 애플리케이션의 상호 운용성을 촉진합니다.
- 모델이 출시된 후에는 합성 데이터 생성과 같은 고급 워크플로우를 포함한 모든 고급 기능이 개발자에게 공개됩니다.
- Llama 3.1 405B에는 개발부터 배포까지 프로세스를 단순화하는 주요 프로젝트가 포함된 내장 도구 선물 팩이 함께 제공됩니다.
새로운 오픈 소스 계약에서 Meta는 진정한 오픈 소스 선량자인 가장 강력한 Llama 3.1 405B를 포함하여 다른 모델을 개선하기 위해 Llama 3을 사용하는 것을 더 이상 금지하지 않는다는 점에 주목할 가치가 있습니다.
첨부된 내용은 92페이지 분량의 논문 교육 보고서 주소입니다.
https://ai.meta.com/research/publications/the-llama-3-herd-of-models/
오픈소스가 이끄는 새로운 시대
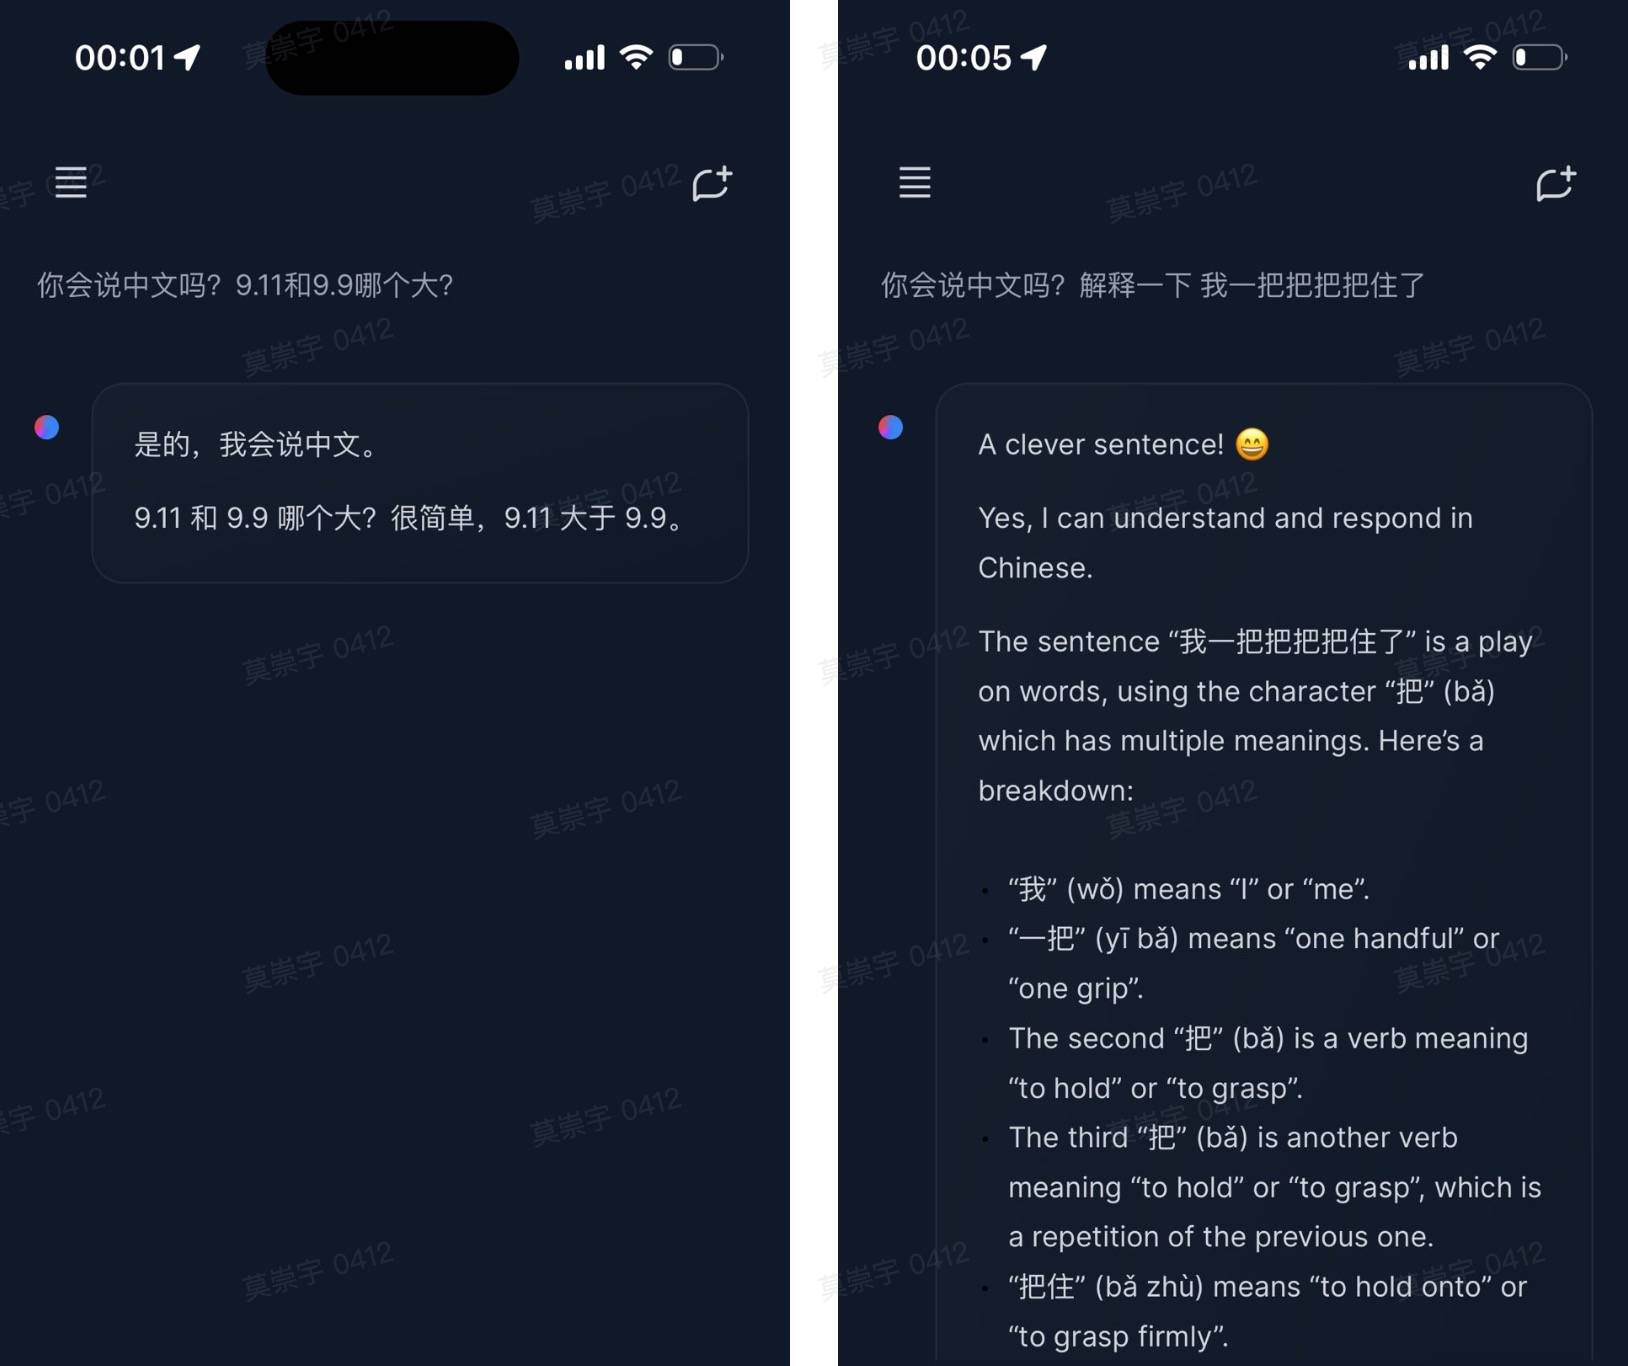
네티즌 @ZHOZHO672070도 Llama 3.1 405B Instruct FP8의 Hugging Chat에 대한 두 가지 고전적인 질문에 대한 답변을 빠르게 테스트했습니다.
아쉽게도 라마 3.1 405B는 '9.11이냐 9.9냐 누가 더 큰가' 문제를 해결하는 과정에서 반전을 겪었지만, 다시 시도한 끝에 정답을 내놨다. "잡았어"라는 병음 주석에 있어서도 그 성능은 만족스럽다.
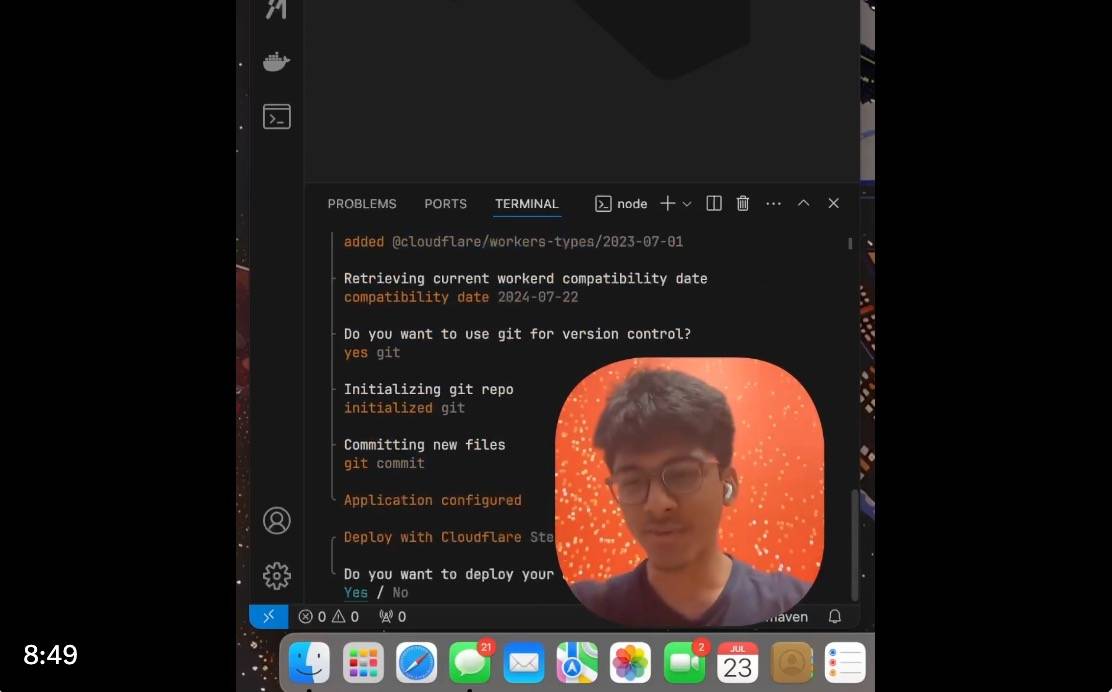
네티즌들은 Llama 3.1 모델을 사용하여 10분 이내에 챗봇을 빠르게 구축하고 배포했습니다.
또한 Llama 내부 과학자인 @astonzhangAZ는 그의 연구팀이 현재 Llama 3에 이미지, 비디오 및 음성 기능을 통합하는 것을 고려하고 있다고 X에서 밝혔습니다.
대형 모델 시대에도 오픈 소스와 폐쇄 소스 간의 논쟁은 계속되고 있지만, 오늘 새로운 Meta Llama 3.1 모델이 출시되면서 이러한 논쟁은 종식되었습니다.
메타는 공식적으로 “지금까지 오픈소스 대규모 언어 모델은 기능이나 성능 측면에서 폐쇄형 모델에 비해 뒤처지는 경우가 대부분이었다”고 공식 밝혔다.
Meta Llama 3.1 405B의 탄생은 모델의 능력이 시작이나 종료에 있는 것이 아니라 리소스 투자, 그 뒤에 있는 사람과 팀 등에 있음을 증명합니다. Meta는 여러 가지 요인으로 인해 오픈 소스를 선택할 수 있습니다. 하지만 이 깃발을 들고 다니는 사람들은 언제나 있을 것입니다.
이러한 상황을 활용한 최초의 거대 기업으로서 Meta는 가장 강력한 폐쇄 소스 대형 모델을 능가하는 최초의 SOTA라는 타이틀도 획득했습니다.
Meta CEO Zuckerberg는 오늘 발표된 "오픈 소스 AI가 앞으로 나아가는 길"이라는 긴 기사에서 다음과 같이 썼습니다.
"내년부터 우리는 미래의 Llama가 업계에서 가장 발전할 것으로 기대합니다. 그러나 그 전에 Llama는 이미 오픈 소스, 수정 가능성 및 비용 효율성 분야를 선도하고 있습니다."
오픈 소스 AI 모델은 폐쇄 소스를 능가하는 것을 목표로 하지 않을 수도 있고, 기술적인 평등을 추구하지 않을 수도 있습니다. 따라서 소수의 사람들이 수익을 창출하는 수단이 되지 않을 것이며, 모든 사람이 AI의 번영에 연료를 추가할 것이라는 희망에서 나오지 않을 것입니다. 생태계.
Zuckerberg는 그의 긴 게시물 끝에 자신의 비전을 다음과 같이 설명했습니다.
저는 Llama 3.1 버전이 업계의 전환점이 될 것이라고 믿으며 대부분의 개발자는 주로 오픈 소스 기술을 사용하는 방향으로 전환하기 시작할 것입니다. 앞으로도 이러한 추세가 계속되기를 기대합니다… 우리는 함께 AI의 이점을 가져오기 위해 최선을 다하고 있습니다. 전 세계 모든 사람에게.
# Aifaner: Aifaner(WeChat ID: ifanr)의 공식 WeChat 공개 계정을 팔로우하신 것을 환영합니다. 더 흥미로운 콘텐츠가 최대한 빨리 제공될 예정입니다.
Ai Faner | 원본 링크 · 댓글 보기 · Sina Weibo