
2013년에도 자율주행은 지금의 AGI나 메타버스처럼 여전히 최첨단이자 섹시한 개념이었다. 인터넷 기업이 본격화하던 시대에도 텐센트는 매년 WE 컨퍼런스를 열어 이에 대해 이야기를 나눴다. 유전자 편집, 뇌-컴퓨터 인터페이스, 우주 탐험 등과 같은 별과 바다 주제 중 일부.
제가 '자율주행'이라는 개념을 처음 접한 것은 2013년 제1회 Tencent WE 컨퍼런스에서였습니다. 당시 한 손님은 다음과 같은 견해를 밝혔습니다.
- 기술적인 문제는 해결하기 어렵지 않지만 법적인 문제는 해결하기 어렵습니다.
- 10년 안에 소비자는 자율주행차를 구입할 수 있게 될 것이다.
- 기계가 내리는 판단의 정확도가 95%에 도달하더라도 인간보다 여전히 더 좋고 빠를 수 있습니다.
10년의 시대가 도래했고 이 말은 일반적으로 실현되었습니다. Carrot Run이 이미 많은 도시에서 대규모로 운행되고 있을 때, 주류 신규 파워 브랜드의 고급 모델은 고급 지능형 주행 기능을 갖추고 있습니다. Tesla FSD V12 버전이 출시됩니다. 자율주행 기술이 L2+ 수준에서 L4 수준으로 이동하고 있습니다. "앉아서 운전할 수 없습니다."
잠깐만 이 사진을 꺼내면 어떻게 반응해야 할까요? 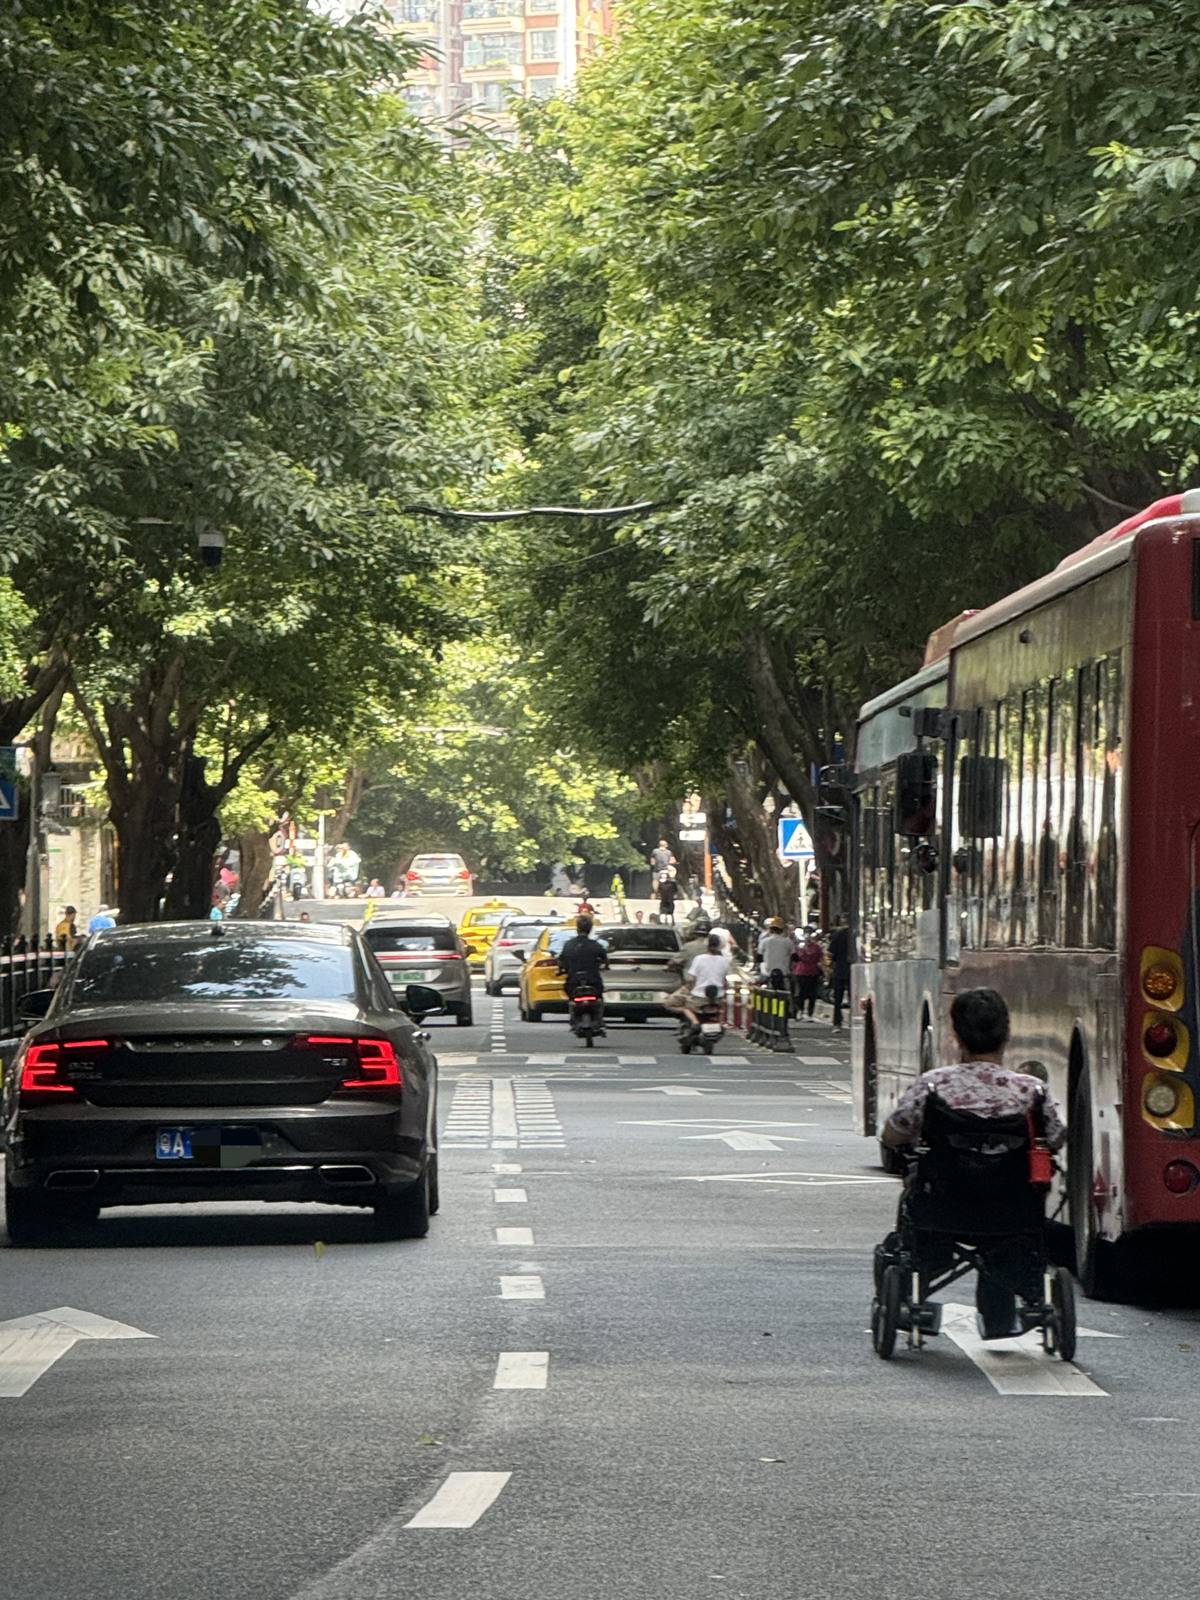
이것은 광저우시의 일상적인 교통 상황의 일반적인 장면입니다. 자동차 차선은 수많은 이륜 전기 스쿠터로 가득 차 있을 뿐만 아니라 극도로 낮은 속도로 달리는 전동 휠체어도 자동차 차선을 달리고 있습니다.
이때 스마트 운전의 장점과 과제가 함께 반영됩니다. 스마트 운전에는 감정이 없고 화를 내지 않으며 도로 분노로 고통받지 않는다는 장점이 있습니다. 과제는 느린 전동 휠체어와 이륜차입니다. 스마트한 주행을 위해서는 예측하고 대처하기가 매우 어려운 시나리오입니다.
실제로 10년 전 자율주행 발전에 대한 예측은 대부분 한 가지 논리에 바탕을 두고 있었다. 도로 위의 자동차와 사람은 교통법규를 준수하고, 빨간 신호에 정지하고 녹색 신호에 주행해야 하며, 모터에 유해한 사람이 나타나지 않아야 한다는 것이다. 차량 차선.
하지만 제조업체가 지능형 주행 기능을 갖춘 자동차를 소비자에게 제공할 때 자동차가 직면하는 상황은 위 그림과 같습니다. 도로는 내 집이고 교통 규제는 무시됩니다.
클래식 스마트 운전 논리: "인식 – 계획 – 제어"
고정밀 지도 솔루션이든 지도 없는 솔루션이든 현재의 주류 지능형 운전 솔루션은 모든 도로 상황과 해당 조치를 소진하고 최대한 많은 것을 달성하기 위해 다양한 도로 시나리오를 기반으로 규칙을 작성하는 수많은 엔지니어에 의존합니다. 가능한 한 지능적인 운전 행동.
그러나 실제 도로 상황은 복잡하고 완벽할 수 없을 뿐만 아니라, 현실 세계 역시 끊임없이 변화하고 있어 언제든지 새로운 도로 장면이 등장합니다. 따라서 이전의 지능형 운전 연구개발은 '무한전쟁'이었다.
예를 들어 7월 이전에는 회전교차로에 진입하고 나가는 장면을 정복할 수 있는 자동차 회사는 거의 없었다. 장면이 복잡하고, 인식이 제한적이며, 계획과 의사결정이 어려웠기 때문이다.
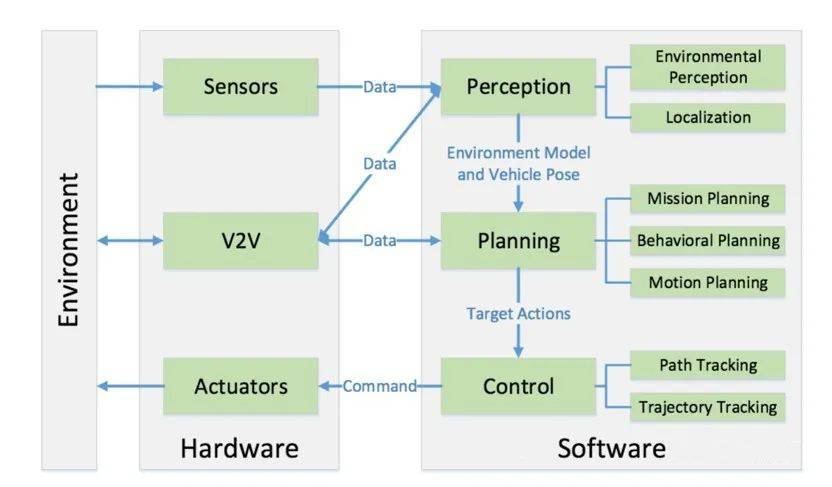
간단히 말해서 Tesla의 FSD V12 버전이 "엔드 투 엔드" 기술 솔루션을 채택하기 전에는 거의 모든 스마트 드라이빙 솔루션이 "인식 – 계획 – 제어"라는 세 가지 주요 모듈로 요약될 수 있습니다. 고전적인 삼분할 법칙(고속도로 장면, 도시 장면, 주차 장면)과 같은 다양한 장면.
이러한 큰 장면은 세분화되고 세분화될 수 있으며, 자동차의 라이더, 밀리미터파 레이더, 카메라 및 위치 확인 시스템이 함께 작동하여 도로, 환경 및 위치 정보를 감지하고 기록합니다. Birds-Eyes-View) 기술 또는 OCC(Occupancy Network) 기술 또는 기타 기술은 이러한 센서에서 얻은 정보를 사용하여 지능형 주행 시스템이 이해할 수 있는 "실제 세계의 가상 투영"을 형성합니다. 세계 투영', 합리적인 이동 경로 및 이동 계획을 계획하고 제어 결정을 도출합니다. 마지막으로 자동차는 결정에 응답하여 '천천히, 왼쪽으로 방향 변경, 왼쪽 유턴 차선 이용'을 형성합니다. 전진, 비상 브레이크 피하기 이륜차가 도로 중앙에 진입하면 계속해서 유턴하는 것이 지능적인 운전 행동입니다.
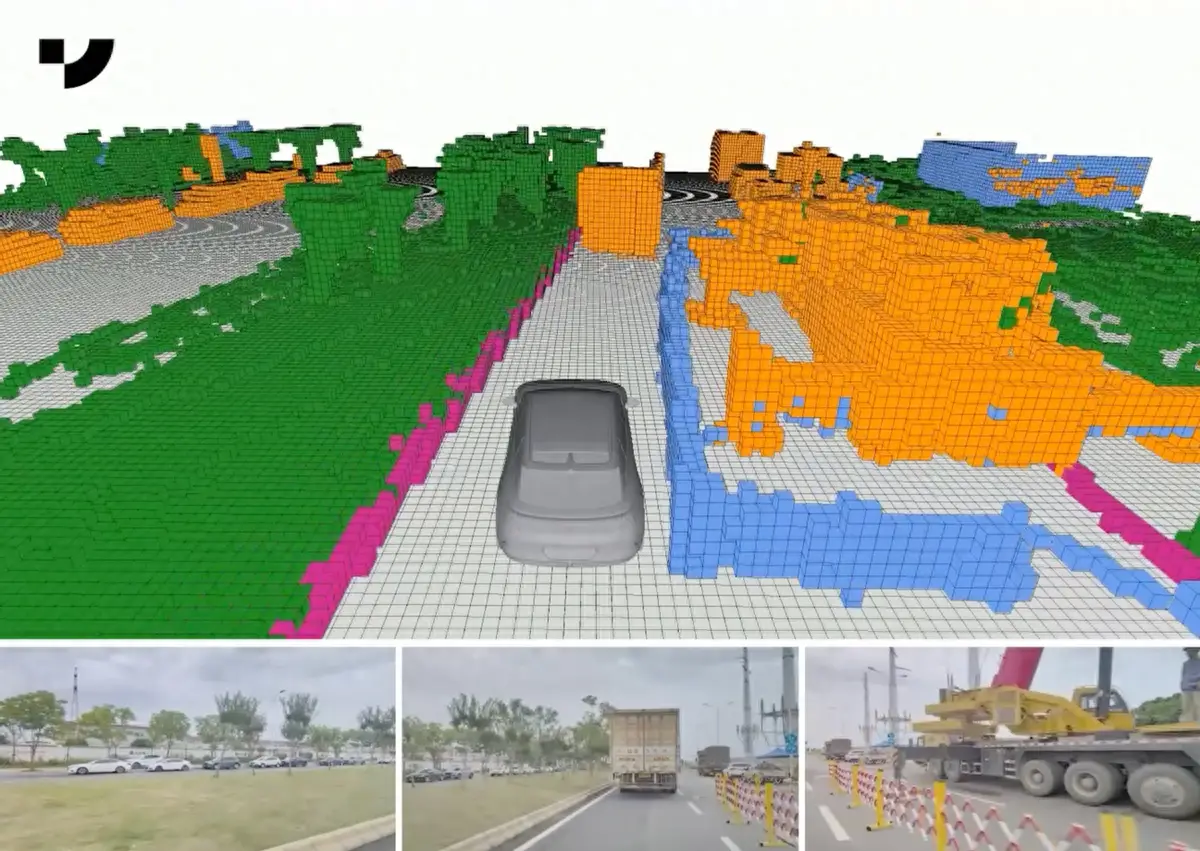
▲ Jiyue Auto OCC 네트워크 점유도
스마트 드라이빙이 OCC 점유 네트워크 기술을 활용한다면, 스마트 드라이빙 시스템에서 외부 세계는 사각형(복셀)으로 구성된 '마인크래프트'와 같다. 이론적으로는 도로에 사각형이 없을 것이고, 차가 대담하게 앞으로 나아갈 수 있을 것이다. 그 앞에 작은 정지 사각형이 있다면 아이스크림 통이 도로 중앙으로 헤매었을 수도 있다. 오른쪽에 있는 길고 느리게 움직이는 막대는 보행자일 수도 있습니다. 왼쪽 차선에서 빠르게 움직이는 매우 큰 직사각형 블록이라면 대형 트럭일 수도 있습니다.
이러한 "인식-계획(의사결정)-제어"라는 일반적인 논리에 따라, 고정밀 지도를 기반으로 한 이전 솔루션이든 다중 센서 융합 및 고도의 로컬 컴퓨팅에 더 의존하는 후속 지도 없는 NOA(자동 항법 지원)이든 상관없습니다. 파워 드라이빙) 솔루션은 이러한 기본 논리에서 벗어나지 않으며, R&D 프레임워크와 엔지니어의 업무도 각 모듈에서 각자의 역할을 수행합니다.
"엔드-투-엔드(end-to-end)"가 출현할 때까지.
"엔드 투 엔드"란 무엇입니까?
인공지능 분야에서 광범위한 사회적 논의를 불러일으킨 세 가지 획기적인 사건이 있습니다.
처음은 1997년 IBM의 체스 로봇 '딥 블루(Deep Blue)'가 체스 명장 게리 카스파로프(Garry Kasparov)를 꺾은 때다. 우리는 엄청난 양의 오프닝 및 엔드게임 체스 기록을 수집한 후 효율적인 검색 알고리즘과 평가 시스템을 사용하여 가장 적절한 플레이 방법을 선택합니다.
즉, Deep Blue가 체스를 둘 때 중간 결정은 인간에게 설명 가능하고 논리적으로 명확합니다.
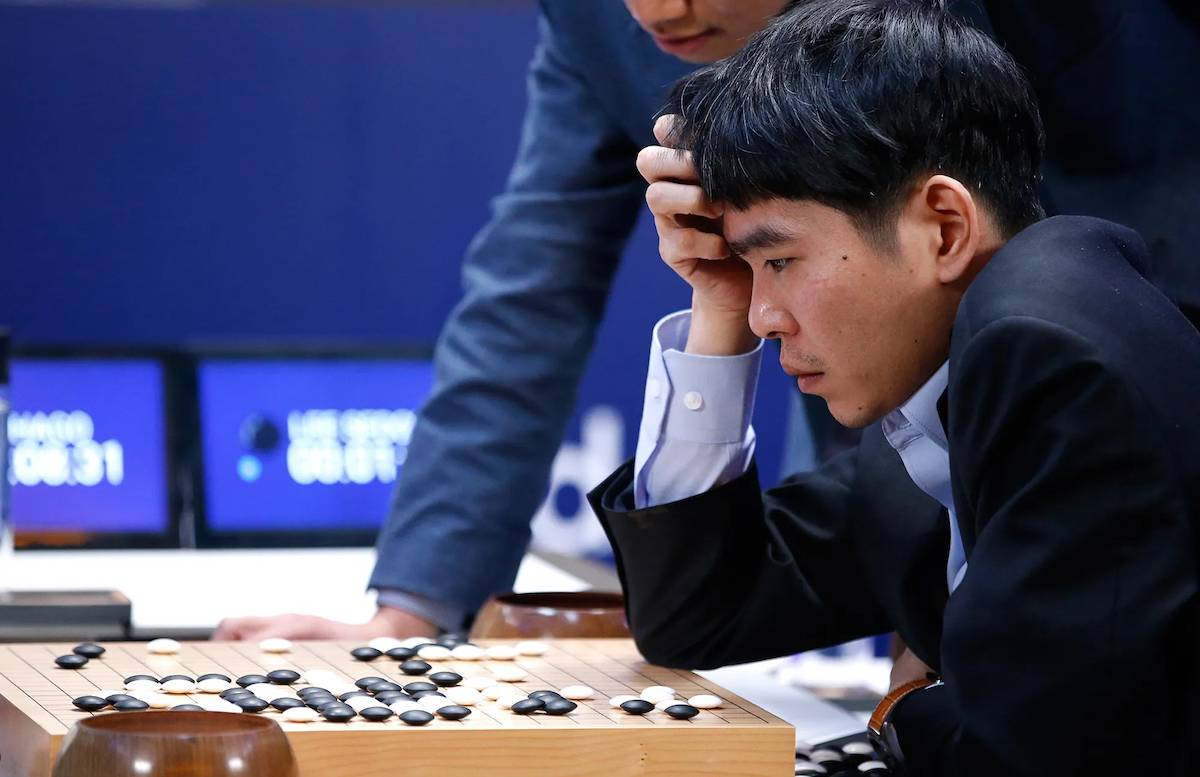
이어 체스보다 더 복잡한 바둑 분야에서는 딥마인드의 알파고가 리세돌과 커지에를 물리치고 인공지능 수준이 모든 인간 체스 선수들의 수준을 훨씬 뛰어넘는다고 발표했다.
AlphaGo의 논리는 체스 기록을 검색하고 일치시키는 것이 아닙니다. 결국 바둑의 보드 그리드와 체스 말의 수는 체스의 수를 훨씬 초과하고 거기에 포함된 가능성은 너무 높습니다. 하지만 신경망의 딥러닝을 기반으로 알파고는 스스로 학습하고 진화할 수 있으며, 승리에 가까워지기 위해 다음 플레이 방법을 알 수 있습니다. 인간의 경우 알파고의 플레이 방법은 인간의 사고 논리와 완전히 다릅니다. 중간? 인공지능 전문가들은 그 논리를 알고 있다.
그러다가 ChatGPT가 등장하게 되었습니다. 대용량 언어 모델 기술의 입력과 출력 사이에는 인공지능 전문가도 설명하기 어려운 '블랙박스'가 있습니다. 답변.
이를 비유하자면, 지능형 주행 기술은 알파고의 컨볼루션 신경망(CNN)과 유사하게 '인지-계획(결정)-제어'의 연구개발 논리를 기반으로 했다. 체스판을 만들고 공간 특징을 추출합니다. 가치 네트워크와 정책 네트워크는 의사 결정을 최적화하기 위한 강화 학습 및 몬테카를로 트리 검색 기술 외에도 계획 및 의사 결정을 제공할 수 있습니다.
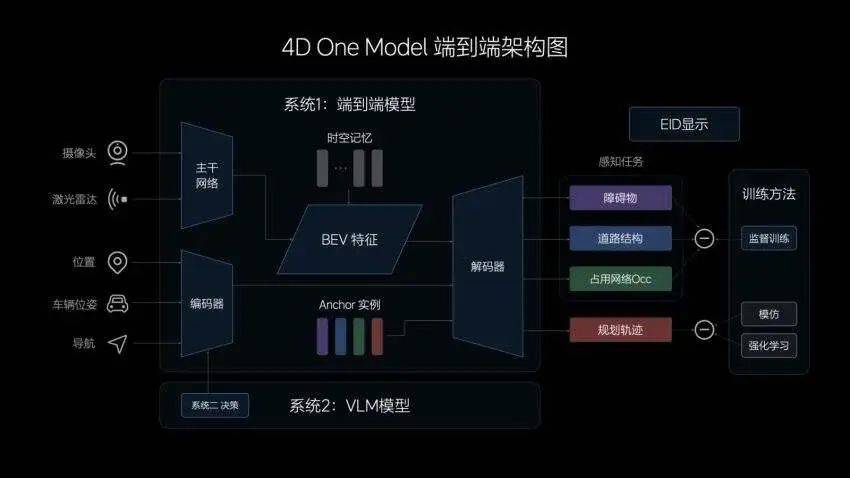
▲ 이상적인 스마트 드라이빙 엔드투엔드 아키텍처 다이어그램
지능형 운전 기술의 "엔드 투 엔드"는 원시 센서 데이터(예: 카메라, 밀리미터파 레이더, LiDAR 등)부터 최종 제어 명령(예: 가속도)에 이르기까지 ChatGPT 뒤에 있는 대규모 언어 모델 기술과 유사합니다. , 제동 등) 조향 등). 물론 이 단계에서 차량을 직접 제어하는 방법은 아직 너무 급진적이므로 이상적인 엔드 투 엔드 솔루션은 궤적만 출력하고 제어하지 않는 것이 차량 제어 이전에는 여전히 많은 제약과 중복 조치가 존재합니다. 이 방법의 목표는 시스템 아키텍처를 단순화하고 단일 신경망이나 모델을 통해 전체 작업을 완료하는 것입니다. 이는 더 이상 그 뒤에 있는 대규모 장면 규칙 코드에 의존하지 않습니다. 이는 완전히 다른 기술적 방향입니다.
이전에 거대 언어 모델이 다수의 매개변수를 강조한 것처럼, end-to-end 뒤의 다중 모드 모델 역시 이러한 양적 변화가 질적 변화로 이어지는 과정을 가지고 있으며, Tesla는 end-to-end를 사용하는 데 앞장섰습니다. FSD V12의 기술과 Musk 이렇게 말해보세요:
100만 개의 비디오 조각으로 훈련하는 것만으로는 충분하지 않습니다. 200만 개라면 약간 더 좋을 것입니다. 1000만 개라면 굉장할 것입니다.
그러나 ChatGPT 또는 기타 생성 AI 도구를 자주 사용하는 사람들은 이러한 도구가 신뢰할 수 없으며 자신있게 잘못된 답변을 출력하는 경우가 많으며 이를 "환상"이라고 합니다.
일반적으로 컴퓨터의 AI 도구가 질문에 맹목적으로 대답하는 데는 재앙적인 결과가 없지만 지능형 운전은 생명 안전과 관련이 있습니다. 운전 행동에 대한 "엔드 투 엔드" 솔루션에는 더 많은 검증과 보험 조치가 필요합니다. 그리고 더 중요한 것은 엔지니어링 문제입니다.
이상적인 지능형 운전 팀과의 대화: "엔드 투 엔드(End-to-end)"는 AI를 자율 주행에 실제로 사용하는 것입니다.
긴 배경 소개를 마친 후 마침내 이상적인 스마트 드라이빙 팀을 인터뷰할 기회를 잡고 "엔드 투 엔드"가 이론에서 운전까지 어떻게 진행되는지 이야기해 볼까요?
Ideal Smart Driving의 R&D 부사장인 Lang Xianpeng은 Aifaner와 Dongchehui에게 다음과 같이 말했습니다.
올해 봄 전략 회의에서 중요한 점은 우리가 경쟁을 너무 많이 추구한다는 것입니다. 예를 들어 우리는 항상 화웨이가 얼마나 많은 도시를 열었는지, 그리고 그 지표가 무엇인지에 초점을 맞췄습니다. 예를 들어, 내가 화웨이보다 낫다는 것은 사용자의 실제 요구를 반영하지 않습니다.
사용자의 운전 요구로 돌아가서, 실제 사용자 요구는 인수율 지표가 얼마나 낮은가가 아닙니다. 사용자에게 필요한 것은 숙련된 운전자처럼 운전할 수 있는 스마트 운전이며, 이러한 의인화된 요구는 원래의 정기적인 모듈식 연구 및 개발에 의존합니다. 구현하기가 어렵습니다. 그러나 이상적인 내부 사전 조사의 "종단 간"이 더 나은 결과를 가져올 것입니다.
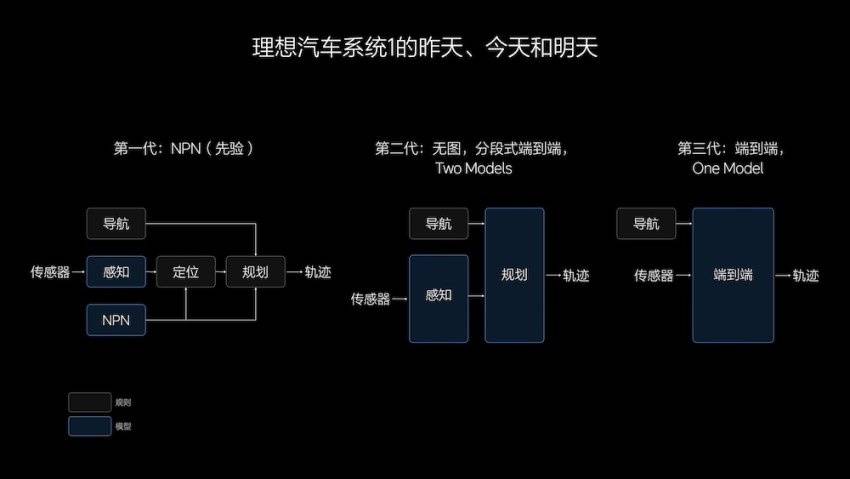
이를 바탕으로 1년 만에 이상적인 지능형 주행 기술 솔루션은 그래프에서 NPN(Neural Prior Network), 그래프리스, 엔드 투 엔드(End-to-End)까지 3세대에 걸친 조정을 거쳤습니다.
Lang Xianpeng은 처음부터 끝까지 본질적인 차이점을 다음과 같이 설명합니다.
표면적으로는 엔드투엔드(end-to-end)가 여러 개의 소형 모델을 대체하는 하나의 대형 모델인 셈이다. 아직은 그렇지 않습니다.
컴퓨팅 성능을 데이터 및 모델과 결합하는 데이터 기반이기 때문에 고도로 자동화된 자체 반복 프로세스입니다. 모델 또는 시스템 자체의 기능을 반복합니다. 그럼 우리는 전에 무엇을 했나요? 우리가 하는 일은 경사로 승하차 기능이나 요금소 통과 기능 등 온갖 시스템 기능이다.
기능과 능력에는 큰 차이가 있습니다.
하지만 실제로 Ideal Intelligent Driving Summer Conference에서 공개된 차세대 자율주행 시스템은 '엔드 투 엔드 + VLM(시각 언어 모델)' 듀얼 시스템 솔루션입니다.
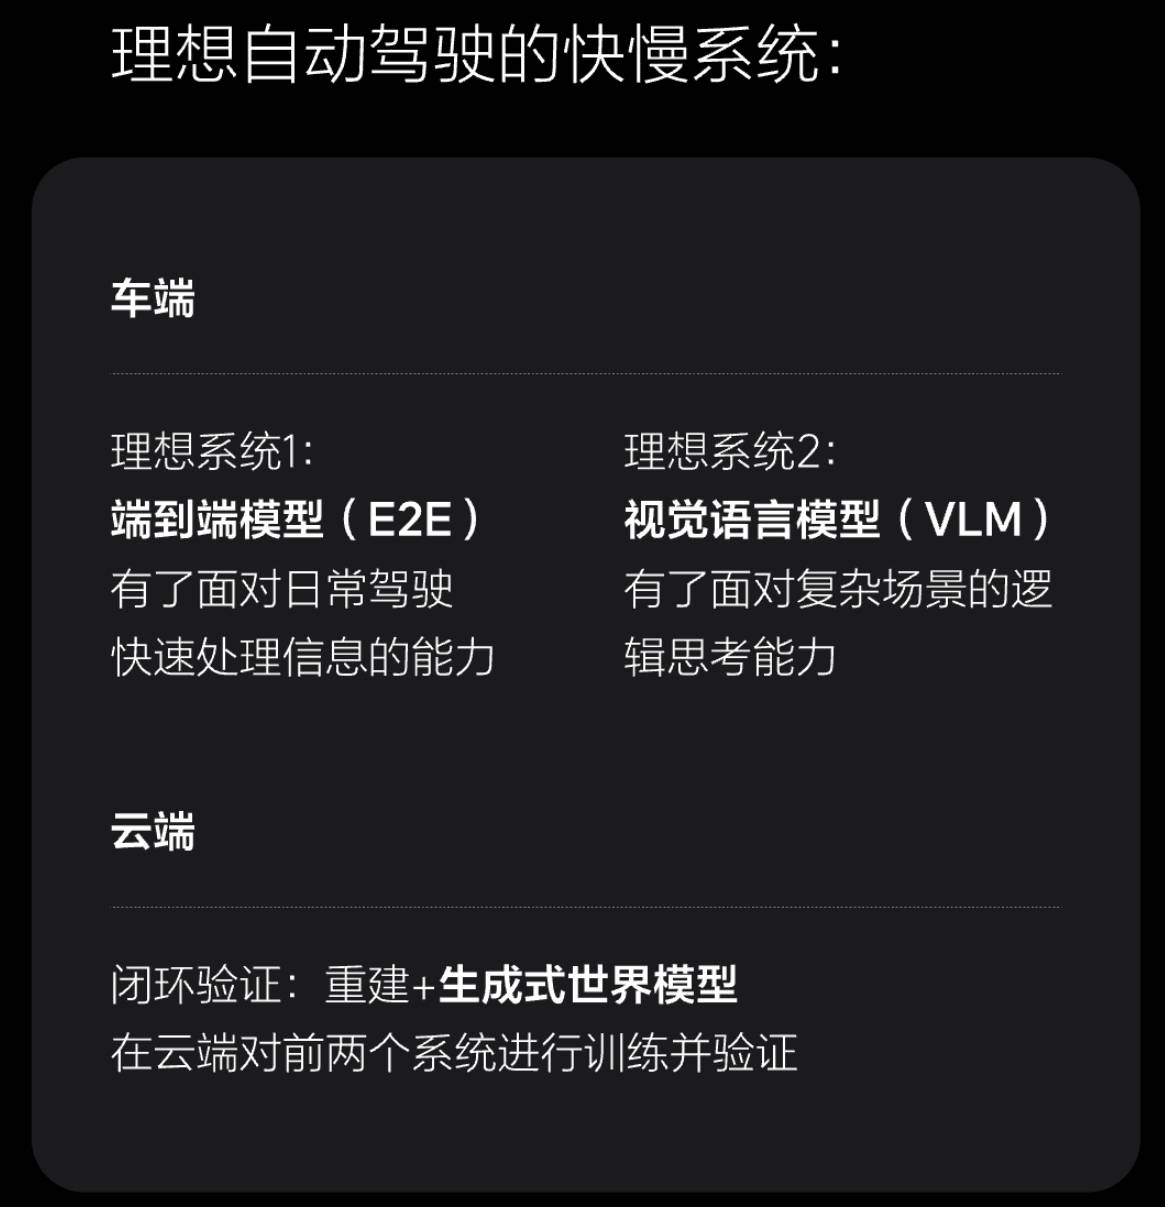
숙련된 운전자처럼 스마트한 운전을 하고 최대한 의인화하는 것이 전제이므로 사람들이 어떻게 일을 하는지 고려해야 합니다. 여기서 이론적 근거는 노벨상 수상자 Daniel Kahneman의 "Thinking, The Theory of Fast and Slow Systems in in"입니다. "빠른 것과 느린 것":
인간의 빠른 시스템은 95%의 시나리오에서 높은 효율성을 유지하기 위해 직관과 본능에 의존하고, 인간의 느린 시스템은 의식적인 분석과 사고에 의존하여 시나리오의 5%라는 높은 상한선을 도입합니다.
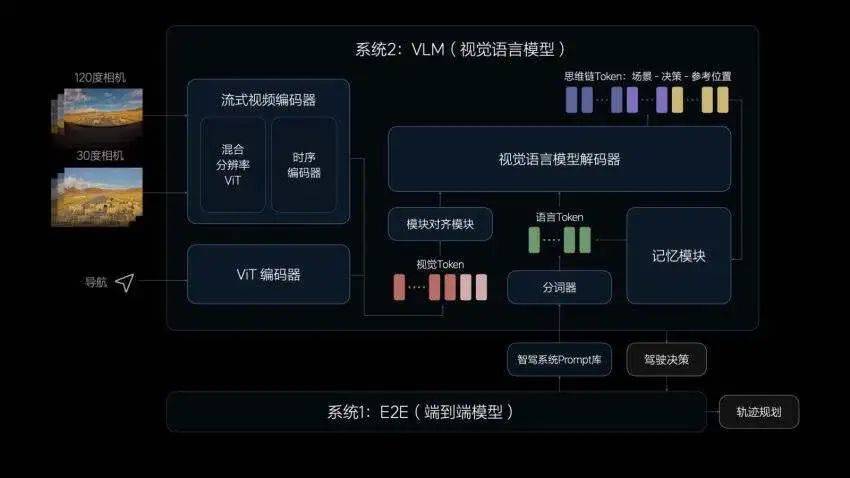
이상적인 "end-to-end + VLM" 이중 시스템의 end-to-end는 일상적인 운전 시나리오에서 정보를 신속하게 처리하는 능력을 갖춘 빠른 시스템이며, VLM 시각적 언어 모델은 논리적으로 사고하는 능력을 갖추고 있습니다. 복잡한 시나리오에서.
이 빠른 시스템은 얼마나 빠른가요?
이상적인 지능형 운전 기술 R&D 책임자인 Jia Peng은 다음과 같이 말했습니다.
이제 종단 간 지연은 센서에서 제어 출력까지 100밀리초 이상에 해당합니다. 과거에는 하위 모듈이 300밀리초에서 거의 400밀리초를 넘겼을 것입니다.
왜 이런 느린 시스템이 필요한가요?
Lang Xianpeng은 다음과 같이 설명했습니다.
우리는 이제 그 (VLM) 기능 중 일부를 탐색하고 있습니다. 방금 언급한 기본 및 보조 차선 선택에 있어서 최소한 어느 정도 가치가 있습니다. 이 기능이 없으면 안전 문제가 없습니다. L3 수준 지능형 운전에 대한 당사의 주요 지원 역할은 엔드투엔드(end-to-end)이며, 이는 정상적인 행동 하에서 개인의 운전 능력을 나타냅니다.
하지만 L4 수준의 지능형 주행에서는 VLM이나 대형 모델이 더 중요한 역할을 해야 합니다. 90% 이상 작동하지 않을 수도 있지만 이러한 내용이 시스템이 L3 수준인지 L4 수준인지를 결정합니다. 이 레벨의 핵심은 VLM이 이 알려지지 않은 시나리오를 실제로 처리할 수 있다는 것입니다.
이상적인 것은 엔드투엔드(end-to-end) 모델로 이루어지는 것이 아니라 전체 장면을 포괄하는 보다 안정적인 듀얼 시스템 솔루션을 채택하는 것입니다. 숙련된 운전자는 VLM 시각 언어 모델이 하한을 지원하지만 상한도 높일 수 있어 더 높은 수준의 자율 주행에 도달할 것으로 예상됩니다.
자세히 살펴보면, 궁극적으로 자동차 제어를 책임지는 근본주의 엔드투엔드와 달리, 이상적인 엔드투엔드는 실제로 자동차를 직접 제어하지 않고 출력 궤적 수준에 도달한다.
Jia Peng은 다음과 같이 말했습니다.
우리의 엔드 투 엔드 모델은 궤적에 도달하고 궤적 뒤에 일부 안전 포켓이 추가됩니다. 모델이 상한에 도달하기 전에 핸들을 돌리는 등 처리해야 할 일이 아직 남아 있기 때문입니다. 그것.
실제 지능형 주행 과정에서 두 시스템은 동시에 작동합니다. Jia Peng은 두 시스템이 어떻게 함께 작동하는지 자세히 설명했습니다.
이 두 시스템은 실시간으로 실행되었으며 함께 실행되는 것은 엔드투엔드입니다. 모델이 더 작기 때문에 주파수는 12Hz로 실행되는 것과 같이 상대적으로 높습니다. 또한, 모델의 크기는 훨씬 더 많은 수의 매개변수(22억 개)를 가지고 있으며 현재 약 3~4Hz에서 실행될 수 있으며 실제로 항상 실행되고 있습니다.
예를 들어, ETC가 고속도로에 진입할 때 VLM은 실제로 어느 차선을 택해야 할지 판단하기 어렵습니다. VLM은 이때부터 항상 존재해 왔습니다. ETC를 선택하려면 ETC 경로를 선택하면 되고, 수동으로 가고 싶다면 수동 경로를 선택하면 됩니다. 그러나 결정 결과와 참조 궤적을 끝까지 던집니다. -to-end 모델. 이 정보는 end-to-end 모델을 추론한 후에 사용됩니다.
실제로 VLM 시각적 언어 모델은 보조 정보이며 최종 궤적 결과는 모델 추론의 결과이며 채택될 확률이 높습니다.
왜 엔드투엔드(end-to-end)가 지능형 운전 분야에서 이렇게 큰 파장을 일으킬 수 있을까요? 아니면 그 뒤에 숨겨진 엄청난 가능성과 "궁극적인 답"을 찾는 데 있어 방향성 중요성 때문일까요?
간단히 말해서, 이 계획에서는 모든 사람이 능력의 한계에 도달하지 못하고 기술 탐구와 엔지니어링 실습이 황무지 영역에 진입했습니다.
Jia Peng은 이중 시스템의 원리와 가능성을 추가로 설명했습니다.
사실, 사람은 이중 시스템입니다. 물리적 구조는 이중 시스템만큼 명확하지 않지만 사람들이 생각하는 방식은 이중 시스템이므로 이를 기반으로 실제 일반화 기능을 갖춘 또 다른 시스템을 추가하려는 아이디어가 있었습니다. 논리적 사고 능력을 위한 시스템으로 VLM이 자연스럽게 떠오릅니다.
VLM은 차량을 직접 제어하지는 않지만 의사 결정을 제공합니다.
이 일은 앞으로 어떻게 전개될 것인가? 예를 들어 Tesla FSD 버전 12.3~12.5에서는 컴퓨팅 성능이 향상되면서 매개변수가 5배 증가하여 충분히 큰 모델을 지원할 수 있습니다.
앞으로는 두 가지 추세가 있을 것으로 생각하는데, 첫 번째는 시스템 1과 시스템 2가 여전히 두 개의 엔드투엔드 모델에 VLM을 더해 하나로 결합될 수 있다는 것입니다. 현재는 상대적으로 느슨하게 결합되어 있으며 향후에는 긴밀하게 결합될 수 있습니다.
둘째, 현재 다중 모드 모델의 대형 모델 개발 추세에서도 배울 수 있습니다. 언어와 음성, 비전, LiDAR를 모두 수행할 수 있는 이러한 기본 다중 모드로 향하고 있다는 것입니다. 앞으로 생각해볼 것.
우리의 패러다임은 (L4 수준 자율 주행) 달성을 지원할 수 있어야 합니다. 왜냐하면 우리는 이미 로봇 구현 지능에 적용되는 프로토타입을 보았기 때문입니다. .궁극적인 답변입니다.
궁극적인 대답은 우리가 이 이론과 프레임워크를 사용하여 실제 인공지능을 만든다는 것을 의미합니다.
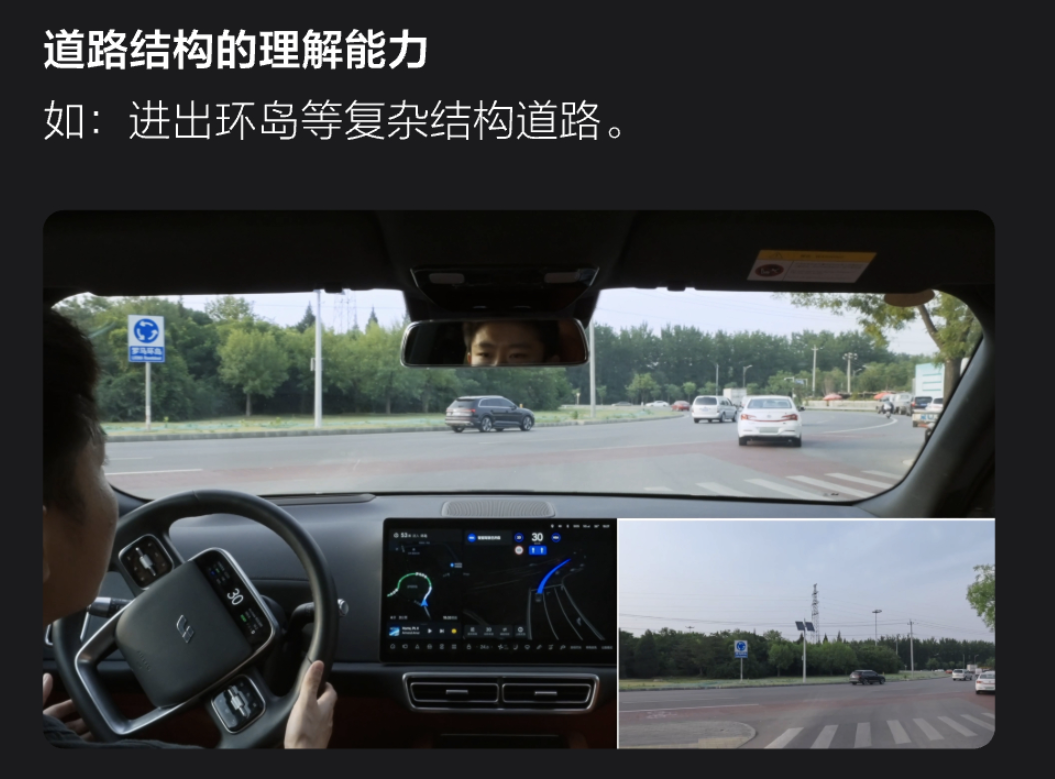
그러나 궁극적인 답에 대해 이야기하기 전에 Jia Peng은 "섬 주변으로 들어가고 나가는" 스마트 운전 문제를 엔드투엔드만이 해결할 수 있는 이유를 설명했습니다.
세그먼트화(지능형 주행 솔루션)라면 전방이 인식되기 때문에 유턴을 하기 위해서는 서로 다른 교차로에 유턴 선이 맞춰져 있어야 한다. 동일하고 곡률이 모두 다르기 때문에 하나의 코드 세트를 사용하여 모든 로터리를 우회하기가 어렵습니다.
로터리에 대한 흥미로운 이야기도 있습니다. 우리(모델 데이터 포함)가 약 80만 개의 클립(비디오 클립)을 가지고 있을 때 로터리를 통과할 수 없었습니다. 그러다가 어느 날 갑자기 100만 개의 클립을 (공급)했다는 것을 알게 되었습니다. 로터리를 지나면서 우연히 100만 개(비디오 클립)에 로터리 데이터가 들어 있었던 것 같습니다.
모델은 실제로 매우 강력합니다. 이는 ETC와 마찬가지로 모델의 매력입니다. 현재 엔드투엔드 버전을 열면 ETC가 이를 통과할 수 있다는 것을 알게 될 것입니다. 그 자체이지만 문제는 이제 ETC 도로인지 인공 도로인지 어떤 도로를 가고 싶은지 알 수 없다는 것입니다. 그러면 나중에 우리가 원하는 것이 안전하지 않을 것입니다. VLM은 한자와 LED 표시기를 이해할 수 있기 때문에 이러한 지침을 제공할 수 있습니다.
엔드-투-엔드 이론적 부분의 내용과 이유에 대해 이제 대략적인 개요를 얻었습니다. 데이터와 모델을 확보한 후에는 실제로 시작합니다. 즉, 이것이 진짜 큰 테스트입니다.
▲이상적인 자동차 제조 워크숍
"엔드 투 엔드 모델을 훈련하는 것은 비약을 만드는 것과 다르지 않습니다."
Lang Xianpeng은 Ai Faner와 Dong Chehui에게 엔드투엔드 모델 훈련에 관한 매우 기괴한 이야기를 들려주었습니다.
올해 초 처음 프로젝트 작업을 시작했을 때 모델을 훈련한 후에는 정상적으로 운전해도 괜찮았지만 빨간 신호등을 기다릴 때마다 차가 이상하게 행동했습니다. 레인. 우리는 이유를 몰랐습니다.
나중에 우리는 엔드-투-엔드 모델을 훈련할 때 빨간 불이 들어오기 전에 대기하던 많은 데이터를 삭제했다는 것을 깨달았습니다. 우리는 수십 초 또는 1분을 기다린 후에는 그 데이터가 쓸모없다고 느꼈습니다. 그러나 나중에 나는 이 데이터가 매우 중요하다는 것을 알게 되었습니다. 이 모델은 일단 속도를 줄이면 차선을 줄이거나 바꿀 필요가 없다는 점을 가르쳐 주었습니다.
이 짧은 이야기는 데이터가 모델의 품질을 크게 결정하지만 모델의 크기는 제한되어 있으므로 모델을 훈련하기 위해 어떤 데이터를 공급하는 것이 실제로 핵심 작업 중 하나임을 보여줍니다.
Lang Xianpeng은 다음과 같이 비유했습니다.
엔드투엔드 모델을 훈련하는 것은 고대 연금술과 다르지 않습니다. 고대에는 화약제련이 일질산염, 이황화물, 목탄을 중심으로 이루어졌고, 생산되는 화약은 상대적으로 위력이 컸다. 다른 비율도 불을 붙일 수 있습니다.
하지만 엔드투엔드 모델을 훈련시키려는 자동차 제조사에게 '연금술'은 단지 비유일 뿐, 구체적인 프로젝트 구현 방법은 아니다. 데이터를 얻는 방법, 선택하는 방법, 훈련하는 방법은 모두 과학적이다. 문제.
다행스럽게도 Ideal에는 몇 가지 타고난 장점이 있습니다. 예를 들어, 자사의 자동차가 잘 팔리고, 신생 자동차 회사 중 판매량이 1위를 차지하는 경우가 많습니다. 현재 도로에 80만 대 이상의 Lideal 자동차가 있으며, 매년 40,000~50,000대가 추가됩니다. , 이 차량은 10억 킬로미터 이상의 데이터를 제공합니다.
또한 Ideal은 오랫동안 데이터의 중요성을 인식하고 데이터에 대한 도구 체인과 같은 기본 기능을 구축했습니다. 예를 들어 Ideal의 백엔드 데이터베이스는 "가까이 우산을 들고 지나가는 보행자"라는 문장을 찾기 위해 단락 검색을 구현했습니다. 비오는 날 빨간 신호등 정지선.”, 해당 데이터를 찾을 수 있습니다. 그 뒤에는 데이터 마이닝 모델 및 장면 이해 모델과 같은 몇 가지 작은 클라우드 모델이 있습니다.
Lang Xianpeng은 이러한 데이터베이스의 도구 체인과 인프라 기능이 어떤 의미에서(중요) 모델의 기능보다 훨씬 더 크다고 믿습니다. 왜냐하면 이러한 좋은 인프라와 데이터가 없으면 모델이 아무리 훌륭하더라도 훈련시킬 수는 없습니다.
기본 기술 솔루션의 변화는 작업 방법의 변화도 의미합니다. 나쁜 사례가 발견되면 이상적인 내부 "심사 데스크" 시스템의 모델은 해당 문제가 어떤 유형의 시나리오에 속하는지 자동으로 분석하고 "심사 제안"을 제공합니다. 그런 다음 모델 학습으로 돌아가서 문제를 해결하세요.
이는 또한 우리가 일하는 방식의 변화를 포함합니다. 원래 특정 문제를 해결했던 사람들은 이제 문제 해결을 위한 도구를 설계하는 사람들이 되었습니다.
"진단 및 치료"의 효율성을 높이기 위해 Ideal은 내부적으로 동시에 여러 모델을 훈련합니다. 이 프로세스는 "연금술"의 개념으로 돌아갑니다. Jia Peng은 다음과 같이 설명했습니다.
모델 학습에는 두 가지 주요 측면이 있습니다. 하나는 데이터 레시피입니다. 사례를 해결하려면 유사한 시나리오에 얼마나 추가해야 할까요? 이는 시나리오마다 데이터 요구 사항이 다릅니다. 두 번째 요점은 모델의 하이퍼 매개변수입니다. 새 데이터를 추가한 후 모델 매개변수를 조정하는 방법은 무엇입니까? 일반적으로 모델의 5~6개 버전이 동시에 학습을 위해 제출되고 어떤 버전이 문제를 해결하는지 확인합니다. 문제를 풀고 점수가 더 높아집니다.
여러 모델을 동시에 교육하면 데이터베이스 인프라에 대한 요구 사항과 컴퓨팅 성능에 대한 막대한 요구 사항이 발생합니다. 이때 "금전적 힘"이 작용합니다. 여기서 이상적인 장점은 자동차가 더 많이 팔리고 더 비싸다는 것입니다. 새로운 자동차 회사 중 최고의 수익과 긍정적인 현금 흐름을 통해 엄청난 컴퓨팅 전력 소비를 지원할 수 있습니다.
랑셴펑(Lang Xianpeng)은 이렇게 말했습니다.
L3 및 L4 자율 주행이 달성되면 연간 훈련 컴퓨팅 전력 지출은 10억 달러에 달할 것으로 예상됩니다. 미래에 우리가 싸울 것은 컴퓨팅 성능과 데이터이고, 이면에는 돈이나 수익성이 있을 것입니다.
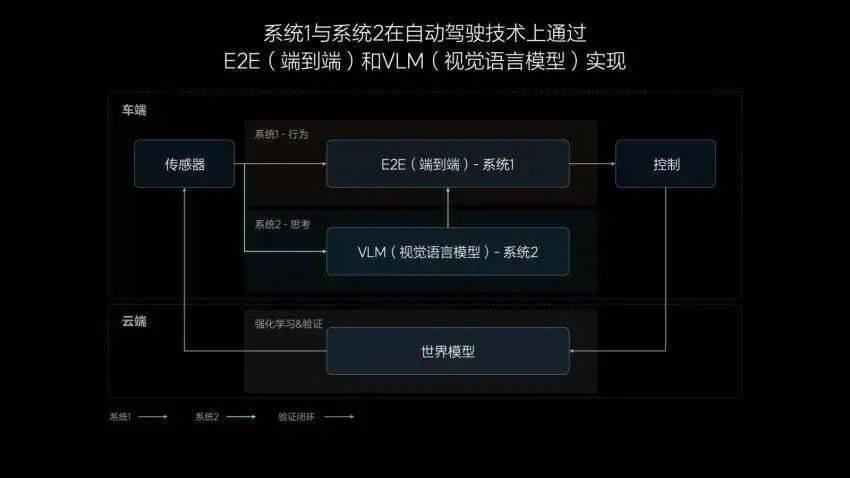
엔드-투-엔드 모델이 기존의 지능형 주행 논리 '인식-계획-제어'의 작업 대부분을 대체할 때 이상과 관련된 지능형 주행 팀의 가장 노동 집약적인 작업도 '머리와 꼬리'에 집중됩니다. "머리는 데이터, 끝은 검증이다.
End-to-End 모델과 VLM 시각적 언어 모델의 두 가지 속도 시스템 외에도 Ideal 내부에는 실험 모델 또는 월드 모델이라고 하는 시스템 3도 있습니다. 지능형 주행 시스템 전체와 보안 수준을 평가합니다.
Lang Xianpeng은 이 시험 시스템을 세 가지 문제 은행 모음에 비유했습니다.
- 실제 문제 은행: 도로에서 운전하는 사람들의 올바른 행동
- 잘못된 문제 은행: 정상적인 테스트 및 운전 중, 사용자 인수, 사용자 종료 및 기타 동작
- 시뮬레이션 질문: 모든 데이터를 기반으로 하나의 인스턴스에서 추론을 도출하고 특정 반복 문제에 대한 가상 유사 시나리오 테스트를 생성합니다.
예를 들어 앞서 언급한 것처럼 스마트 운전을 숙련된 운전자처럼 의인화하려면 이 실제 테스트 뱅크의 운전 행동이 이상적인 테스트 모델의 "실제 테스트 뱅크"와 같아야 합니다. 내부 점수 90점 이상을 선택합니다. 운전자의 운전 행동은 이상적인 자동차 운전자의 3%에 불과하며 운전의 순조로움, 운전의 위험 정도 등에 따라 달라집니다. 예를 들어 운전자가 종종 AEB 자동 비상 제동을 활성화하면 그의 운전 행동이 너무 급진적이 될 것입니다.
실험 모델을 광범위하게 테스트한 후 "얼리버드 사용자"를 위한 테스트 버전도 출시될 예정입니다. 이는 수천 대의 사용자 자동차가 실제 장면과 시나리오에서 작동할 수 있는 새로운 버전의 스마트 운전 시스템을 받게 된다는 것을 의미합니다. 비인지적 "섀도우 모드"는 어떤 자동차 제조업체의 테스트 차량보다 큰 규모의 도로에서 실제 검증 및 테스트를 수행합니다.
수천 명의 얼리버드 사용자가 테스트하고 검증한 데이터는 자동으로 전송되고, 자동 분석되며, 새로운 테스트 및 전달을 위해 자동으로 반복적으로 훈련됩니다.
즉, 데이터 수집, 모델 훈련, 실험적 검사 및 사용자 전달은 사람의 참여가 거의 없이 자동화된 순환 논리로 가득 찬 프로세스입니다.
Lang Xianpeng과 Jia Peng에 따르면 "엔드 투 엔드 + VLM"으로 전환한 후 업계는 인간의 영역에 가까운 위치에 도달했습니다. 물론 실용적일 필요도 있습니다. 예를 들어 현재는 엔드투엔드 모델만 궤적을 출력하고 궤적 이후의 제어는 안전해야 합니다. 또 다른 예는 컴퓨팅 성능을 고려하는 것입니다. : 이전에도 엔지니어 수가 필요했고, 앞으로는 그래픽 카드 수가 필요할 것입니다.
컴퓨팅 성능이 없으면 모든 것이 환상입니다.
이익도 없고 컴퓨팅 파워도 환상일 뿐이다.
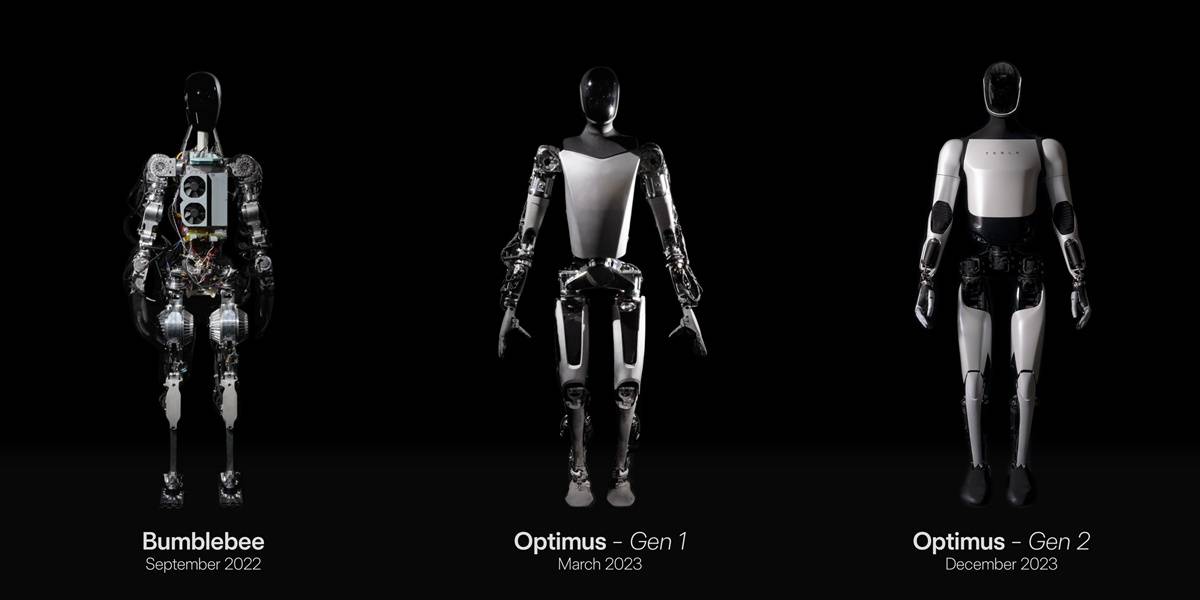
다시 '궁극적 답변'에 대해 이야기해 보겠습니다. 이상, Tesla와 OpenAI는 서로 다른 경로를 통해 동일한 목표에 도달합니다.
머스크가 "테슬라는 단순한 자동차 회사가 아닌 AI와 로봇공학 회사"라고 거듭 강조한 것처럼, 인터뷰에서 랑셴펑(Lang Xianpeng)과 지아펑(Jia Peng)도 이상적인 자동차를 바퀴 달린 로봇에 비유하며 프로토타입 애플리케이션에 대해서도 이야기했다. "end-to-end + VLM" 프레임워크를 사용하여 휴머노이드 로봇과 같은 구현된 지능형 캐리어를 구현합니다.
Tesla의 Optimus 로봇은 Musk의 더 큰 비전을 담고 있으며 물론 Optimus 로봇이 비교적 적은 정보를 공개하기 때문에 FSD의 또 다른 운반자입니다. 그러나 로컬 정보에 의존하는 "엔드 투 엔드" 모델이 있습니다. 카메라와 센서는 환경 정보를 입력합니다. 그런 다음 공동 제어 시퀀스를 직접 출력합니다.
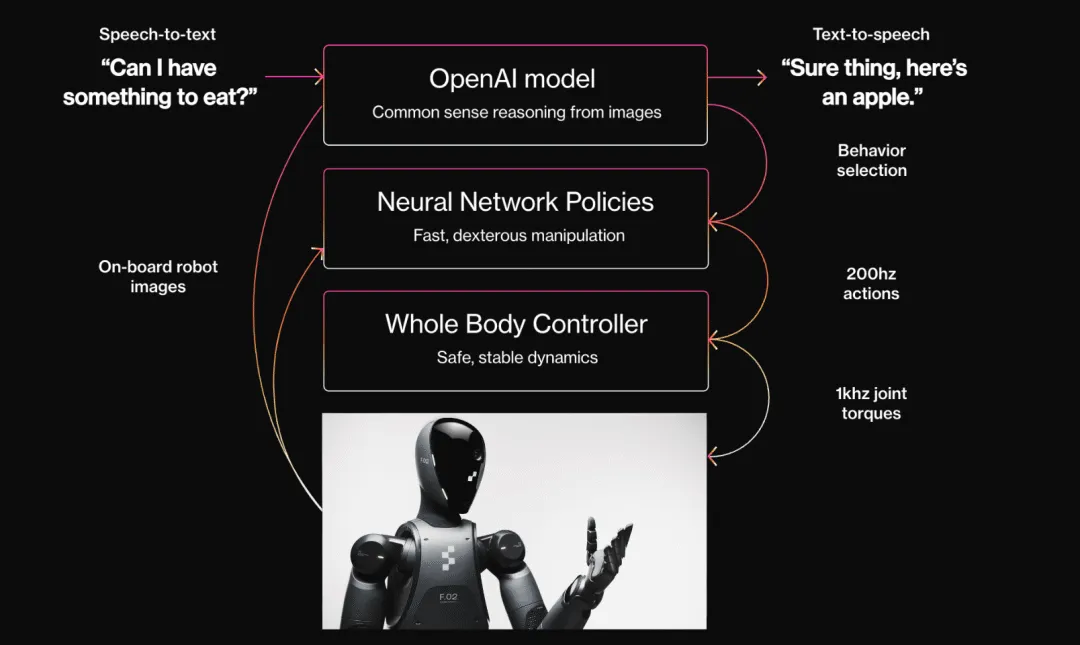
또한 OpenAI와 NVIDIA가 투자한 Figure Robots는 VLM 시각적 언어 모델이 중요한 기능인 "세계에서 가장 진보된 AI 하드웨어"라고 주장하면서 두 번째 휴머노이드 로봇인 Figure 02를 방금 출시했습니다. 머리, 전면 및 후면 몸통에 각각 6개의 RGB 카메라가 장착된 Figure 02는 AI 기반 비전 시스템을 통해 물리적 세계를 감지하고 이해할 수 있습니다. 공식 설명에 따르면 Figure 02는 "초인적인 비전을 가지고 있습니다."
물론 인간과 소통하기 위해 OpenAI가 제공하는 대규모 언어 모델도 당연히 가지고 있습니다.
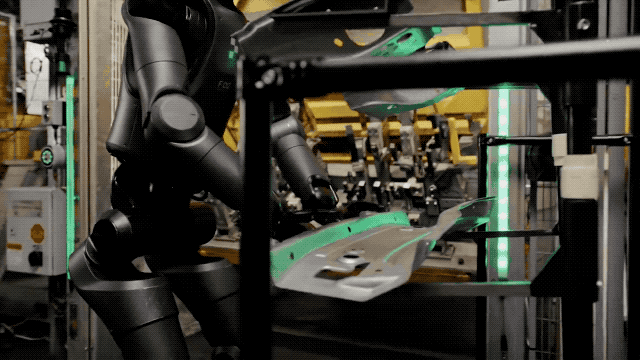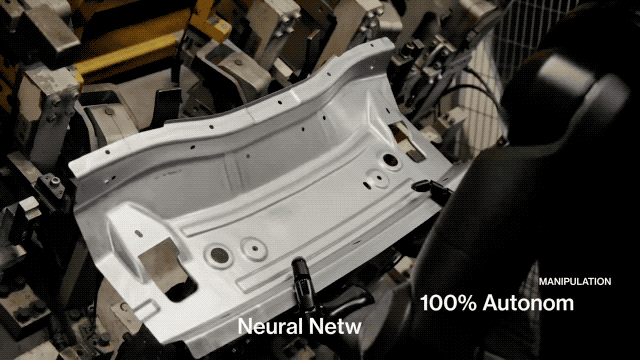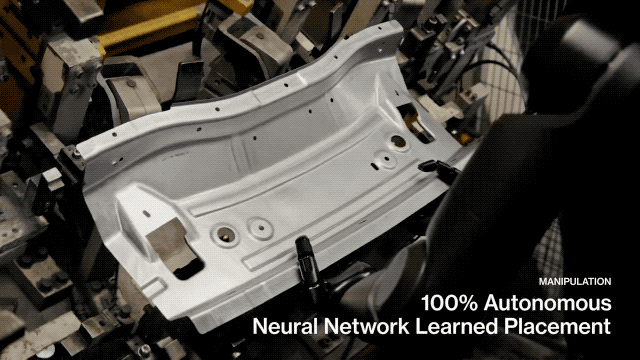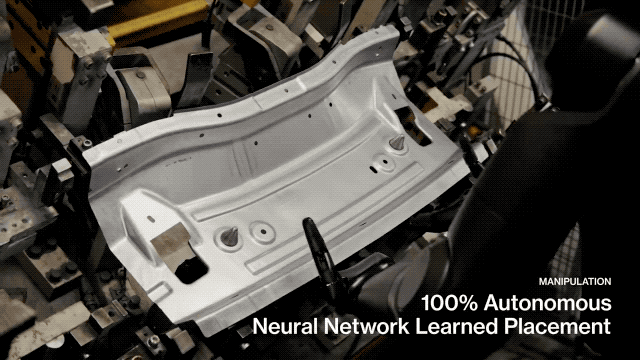
마찬가지로 Optimus 로봇은 Tesla의 자동차 공장에서 작업(및 훈련)을 시작했으며 Figure 02도 BMW의 자동차 공장에서 테스트 및 훈련을 받았습니다. 둘 다 몇 가지 간단한 작업을 완료할 수 있으며 지속적으로 발전하고 있습니다.
이상적인 자동차인 테슬라 옵티머스 로봇과 피규어 로봇은 상관관계가 거의 없어 보이지만, 좀 더 깊이 파고들면 AI에 대한 근본적인 기술적 논리와 사고방식은 실로 같은 목표에 대한 서로 다른 접근방식인 것이 '궁극적 답'의 유래이기도 하다. .
우리는 수십 년 동안 인공지능에 대해 이야기해 왔고, 마침내 초점이 인공지능에서 지능으로 옮겨졌습니다.
# Aifaner: Aifaner(WeChat ID: ifanr)의 공식 WeChat 공개 계정을 팔로우하신 것을 환영합니다. 더 흥미로운 콘텐츠가 최대한 빨리 제공될 예정입니다.
Ai Faner | 원본 링크 · 댓글 보기 · Sina Weibo